Ce qu’il faut retenir
- Supprimer un fichier ne retire pas automatiquement ses fragments, ses vecteurs, ses réponses en cache et ses copies de sauvegarde.
- Une suppression vérifiable exige des identifiants de provenance et un inventaire des dérivés.
- La restauration doit rejouer les retraits avant de remettre un index à disposition des utilisateurs.
Références techniques consultées le 1er octobre 2026. Ce guide décrit une organisation technique ; les obligations de conservation demandent un examen propre au contexte.
Le document a été supprimé de l’espace partagé. Quelques jours plus tard, l’assistant en restitue encore une phrase. Rien de mystérieux : la pièce avait été découpée, copiée dans un index, puis utilisée pour des réponses conservées dans un cache. La suppression visible a traité l’origine, pas les objets qui permettaient encore de retrouver son contenu.
Dessiner le parcours des copies et des dérivés
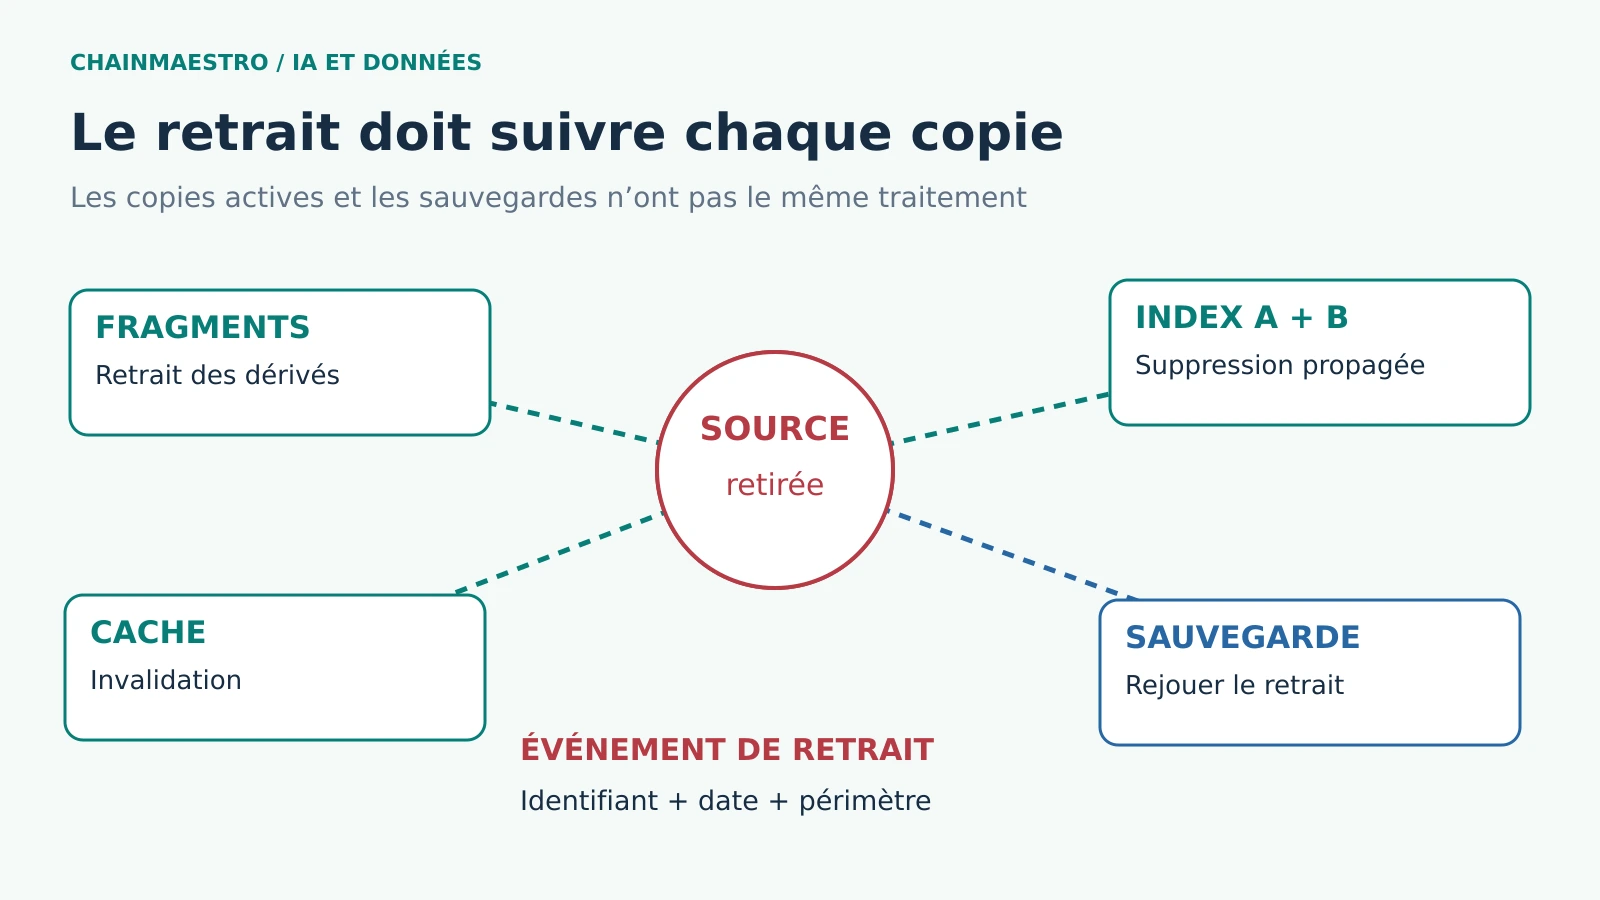
Un RAG transforme généralement une source en texte extrait, fragments et représentations vectorielles. Il conserve des métadonnées, parfois le texte intégral, puis produit des résultats de recherche et des réponses. D’autres copies peuvent exister dans les journaux, les espaces de test, les exports et les sauvegardes. Le nombre exact dépend de l’architecture ; il faut l’inventorier au lieu de le présumer.
Un vecteur n’est pas une anonymisation automatique. Il reste un objet dérivé dont le contexte d’utilisation et les risques doivent être analysés. Le fait qu’un humain ne lise pas directement ses nombres ne suffit pas à exclure toute information associée. Les métadonnées et les fragments adjacents sont souvent plus immédiatement révélateurs que le vecteur lui-même.
La documentation Qdrant sur les points et leurs suppressions illustre le niveau technique d’un retrait dans un moteur vectoriel. Un point supprimé dans une collection ne décrit pas, à lui seul, l’état des autres services ni des copies hors de cette collection. La preuve doit suivre le périmètre complet de l’application.
La provenance rend la suppression possible
Attribuer un identifiant stable à la source et une version à son contenu. Chaque fragment référence ces deux valeurs, ainsi que son emplacement. Les embeddings, les caches et les sorties conservées doivent être reliés au document lorsque leur suppression ou leur invalidation peut être nécessaire. Un nom de fichier libre n’offre pas une association assez sûre.
| Objet | Action envisagée | Preuve à conserver |
|---|---|---|
| Source active | Retrait ou accès bloqué | Identifiant et version retirés |
| Texte et fragments | Suppression des objets dérivés | Inventaire traité et résultat |
| Index | Suppression dans toutes les représentations actives | Recherche de contrôle et état de traitement |
| Caches et sorties | Invalidation ou retrait selon politique | Périmètre et expiration vérifiés |
| Sauvegardes | Calendrier adapté et contrôle de restauration | Retrait rejouable avant réouverture |
Conserver un événement de retrait avec une information suffisante pour empêcher la réintroduction, sans y recopier la donnée que l’on cherche à supprimer. L’événement peut contenir un identifiant interne, la date et le périmètre. Son propre accès et sa durée de conservation doivent être définis. Un registre de suppression qui devient une archive complète des contenus retirés contredit son objectif.
Les intégrations API doivent transmettre le retrait à chaque consommateur concerné. Un accusé de réception indique qu’une demande a été reçue ; la preuve finale indique que les objets attendus ont été traités. Conserver les deux états évite de déclarer terminée une opération seulement mise en file.
Distinguer inaccessibilité et effacement
Une première mesure peut retirer immédiatement le document des recherches. Elle réduit le risque de restitution pendant que l’effacement des dérivés se poursuit. Elle doit être présentée comme une restriction d’accès ou une invalidation, selon sa nature, sans être confondue avec la disparition de toutes les copies.
La recherche de contrôle doit utiliser des éléments distinctifs et vérifier les différents chemins : recherche vectorielle, lexicale, historique et accès direct au fragment. Une absence dans les premiers résultats ne prouve pas une suppression. Le document peut rester récupérable par une autre requête ou un identifiant. Les contrôles d’inventaire et les essais de restitution se complètent.
Les retraits doivent couvrir l’index précédent lorsqu’une migration est en cours. Sinon, un retour en arrière peut faire réapparaître la donnée. Le cadre de sécurité des agents IA concerne donc autant les opérations de maintenance que la génération elle-même. Une restauration est une nouvelle mise à disposition, avec ses propres contrôles.
Les sauvegardes ont un calendrier, mais aussi une porte de sortie
Une sauvegarde figée peut contenir des objets retirés depuis sa création. L’architecture doit décrire sa durée, ses accès et la procédure qui empêche leur retour dans l’état actif. Certaines politiques prévoient une expiration des sauvegardes ; d’autres autorisent un effacement ciblé. Le choix dépend du système et des contraintes de conservation, et mérite une validation adaptée.
Lors d’une restauration, appliquer les événements de retrait sur le contenu restauré avant de rouvrir le service. Vérifier aussi les mises à jour de droits et les documents remplacés. Une sauvegarde techniquement valide peut être fonctionnellement obsolète. Tester cette séquence hors production révèle les dépendances oubliées, notamment les caches et les copies d’index annexes.
Le référentiel The ML Test Score, publié par des chercheurs de Google, place tests et suivi au cœur de la préparation opérationnelle des systèmes de machine learning. Ici, la suppression et la restauration méritent ce même statut : des parcours éprouvés, avec critères de réussite, plutôt que des opérations supposées évidentes.
Le dossier client retiré pendant une migration
Exemple hypothétique. Une application de support maintient deux index le temps de remplacer ses embeddings. Un dossier client doit être retiré du périmètre de l’assistant. Le fichier d’origine est supprimé et l’index actif est corrigé, mais le deuxième index contient encore les fragments. Une bascule ultérieure pourrait les rendre de nouveau consultables.
La procédure associe le retrait à l’identifiant du dossier, traite les deux représentations et invalide les caches qui référencent la pièce. La preuve conserve le périmètre traité, l’état final et les exceptions éventuelles. La copie de sauvegarde est inscrite au calendrier prévu ; toute restauration doit appliquer le retrait avant ouverture.
Un test utilise une version factice du dossier et des phrases distinctives. Il vérifie absence de récupération et impossibilité d’accès direct dans les chemins recensés. Il simule ensuite une restauration et une réingestion depuis la source. Le système ne doit pas reconstituer les dérivés d’une pièce encore marquée comme retirée, même si un ancien connecteur la représente comme nouvelle.
Une demande de suppression est un processus
- Qualifier le périmètre. Source, versions, finalité du retrait et systèmes concernés ; identifier les éventuelles conservations obligatoires.
- Bloquer la restitution active. Retirer les documents des parcours autorisés pendant le traitement.
- Traiter les dérivés. Fragments, vecteurs, index lexicaux, caches, tests et sorties selon le périmètre validé.
- Vérifier le résultat. Comparer l’inventaire attendu aux objets traités et contrôler les voies de consultation.
- Documenter les copies restantes. État, accès, calendrier et règle de restauration ; ne pas masquer une exception derrière un statut global.
- Clore avec une preuve. Responsable, date et éléments vérifiés, en limitant les données consignées.
Le coût de ce processus complète le budget d’exploitation de l’IA. La provenance construite au début réduit souvent ce coût. Sans elle, une suppression devient une recherche manuelle dans plusieurs services, avec une forte incertitude sur les copies oubliées.
Retirer d’un index ne désapprend pas un modèle
Si les données ont servi à entraîner ou ajuster un modèle, supprimer l’index ne modifie pas ses paramètres. Ce périmètre exige une analyse distincte. Le présent guide couvre une application documentaire et ses copies repérables ; il ne promet pas un désapprentissage ni un effacement absolu sur un système non inventorié.
Les modèles et outils exploités en interne facilitent parfois la maîtrise des copies, mais ils demandent la même discipline. Avant de généraliser un RAG, faire un exercice complet de retrait puis de restauration sur une donnée factice. C’est une façon directe de savoir si la promesse de suppression correspond aux capacités réelles du produit.
Sources et références
Sources primaires consultées le 1er octobre 2026 : Qdrant, points et opérations de suppression ; Google Research, The ML Test Score. Les parcours de suppression décrits sont des recommandations techniques ; ils ne fixent pas de délai légal universel.