Ce qu’il faut retenir
- Un SLO mesure un résultat utile au lecteur ou à l’utilisateur, sur une fenêtre définie.
- Le budget d’erreur exprime la part d’échec tolérée par cet objectif. Sa consommation n’est pas un droit de provoquer des incidents.
- La politique doit préciser ce qui change lorsque le budget se dégrade : livraisons, priorités et traitement des causes.
Le service affiche une disponibilité élevée, mais les utilisateurs attendent trop longtemps pour terminer une commande. L’équipe ne sait pas si elle doit livrer la prochaine fonction ou traiter les ralentissements. Un SLO, objectif de niveau de service, sert à rendre cet arbitrage explicite. Sa valeur ne vient pas du nombre de neuf dans une présentation : elle vient de la décision que l’équipe sait prendre à partir d’une mesure comprise.
Mesurer l’expérience qui compte
Un SLI, indicateur de niveau de service, décrit une proportion ou une mesure pertinente. Un SLO lui associe une cible et une période. La méthode Google SRE pour mettre en œuvre les SLO propose de partir des parcours et de définir les bons événements. « Le serveur répond » peut être insuffisant si une réponse réussie ne contient pas le résultat attendu.
Pour une API interactive, un événement satisfaisant peut être une requête éligible qui réussit sous un délai défini. Pour une tâche asynchrone, ce peut être un travail terminé correctement avant une échéance. Un cache qui sert rapidement une donnée trop ancienne pose une autre question : la fraîcheur peut nécessiter son propre indicateur. Mélanger ces qualités dans un compteur opaque empêche d’identifier le problème.
Les requêtes éligibles sont définies avant la mesure. Les erreurs dues à une donnée utilisateur invalide peuvent être exclues selon le contrat, mais l’exclusion ne doit pas cacher les refus d’un service saturé. Les sondes, bots et reprises sont traités de façon cohérente. Le dénominateur doit correspondre à la promesse faite, avec des segments pour les usages critiques.
Une arithmétique simple, un sens précis
Pour un objectif de 99,9 % de bons événements, la part tolérée de mauvais événements est de 0,1 %. Exemple hypothétique : sur un million de requêtes éligibles pendant la fenêtre, mille peuvent échouer selon la définition retenue avant que le budget ne soit entièrement consommé. Ce calcul porte sur les requêtes. Il ne se traduit pas automatiquement en minutes d’indisponibilité, car le trafic varie.
Un objectif fondé sur le temps utilise un autre dénominateur. Le document indique lequel est choisi, la fenêtre et le traitement des données manquantes. Une mesure absente ne doit pas être transformée silencieusement en succès. Une fenêtre glissante et une fenêtre calendaire peuvent produire des décisions différentes ; l’équipe doit connaître le comportement de l’outil qu’elle consulte.
Le budget restant peut aussi être mal interprété. Il ne permet pas de programmer une panne sous prétexte que la moyenne restera bonne. Une interruption qui touche tous les clients critiques peut être inacceptable même avec peu d’événements. La lecture par parcours et par gravité complète le ratio global, sans rendre l’objectif impossible à expliquer.
Le budget devient une règle de travail
La politique de budget d’erreur présentée par Google SRE relie les performances du service aux décisions de livraison et de fiabilité. Une équipe peut convenir de ralentir certains changements, de privilégier les corrections ou de revoir une dépendance lorsque le budget est épuisé. La règle précise les exceptions, notamment les changements qui réparent un incident ou améliorent directement la sécurité.
La politique évite un débat improvisé entre produit et exploitation au milieu de la panne. Elle ne sert pas à attribuer une faute à une personne. Les causes peuvent être un quota fournisseur, une hausse d’usage, une architecture fragile ou une mauvaise définition de l’indicateur. La décision doit traiter ce qui réduit réellement les mauvais événements, pas simplement déplacer un compteur.
Le coût entre dans l’arbitrage. Une cible plus stricte peut demander de la redondance, des contrôles et une astreinte supplémentaires. L’analyse du coût réel de l’infrastructure aide à relier cette dépense à la valeur du parcours protégé. Un objectif ambitieux sans moyen opérationnel ni responsable produit reste une promesse de papier.
Une recherche tient, une commande échoue
Exemple hypothétique : une boutique numérique sert un million de recherches et 20 000 validations de commande sur la période. Quelques milliers de recherches lentes pèsent sur le ratio global, tandis que 200 commandes échouées représentent une perte beaucoup plus sensible. L’équipe définit des objectifs distincts pour ces deux parcours. Elle peut ainsi protéger la commande plutôt que laisser la masse de recherches masquer ses erreurs.
Un ralentissement du paiement provoque des reprises côté client. L’indicateur précise si une tentative et une transaction métier sont comptées séparément. L’investigation rapproche les identifiants pour éviter de confondre dix requêtes répétées avec dix clients distincts. Les erreurs dues à la dépendance restent visibles dans le parcours utilisateur, même si l’équipe ne les a pas causées directement.
La fiche minimale d’un objectif
| Champ | Exemple hypothétique | Pourquoi il compte |
|---|---|---|
| Parcours | Validation de commande | Relie la mesure à une valeur produit |
| Bon événement | Confirmation valide avant l’échéance | Évite le simple succès HTTP |
| Dénominateur | Demandes éligibles définies | Rend le ratio interprétable |
| Fenêtre et cible | Valeurs convenues par l’équipe | Fixe le calcul du budget |
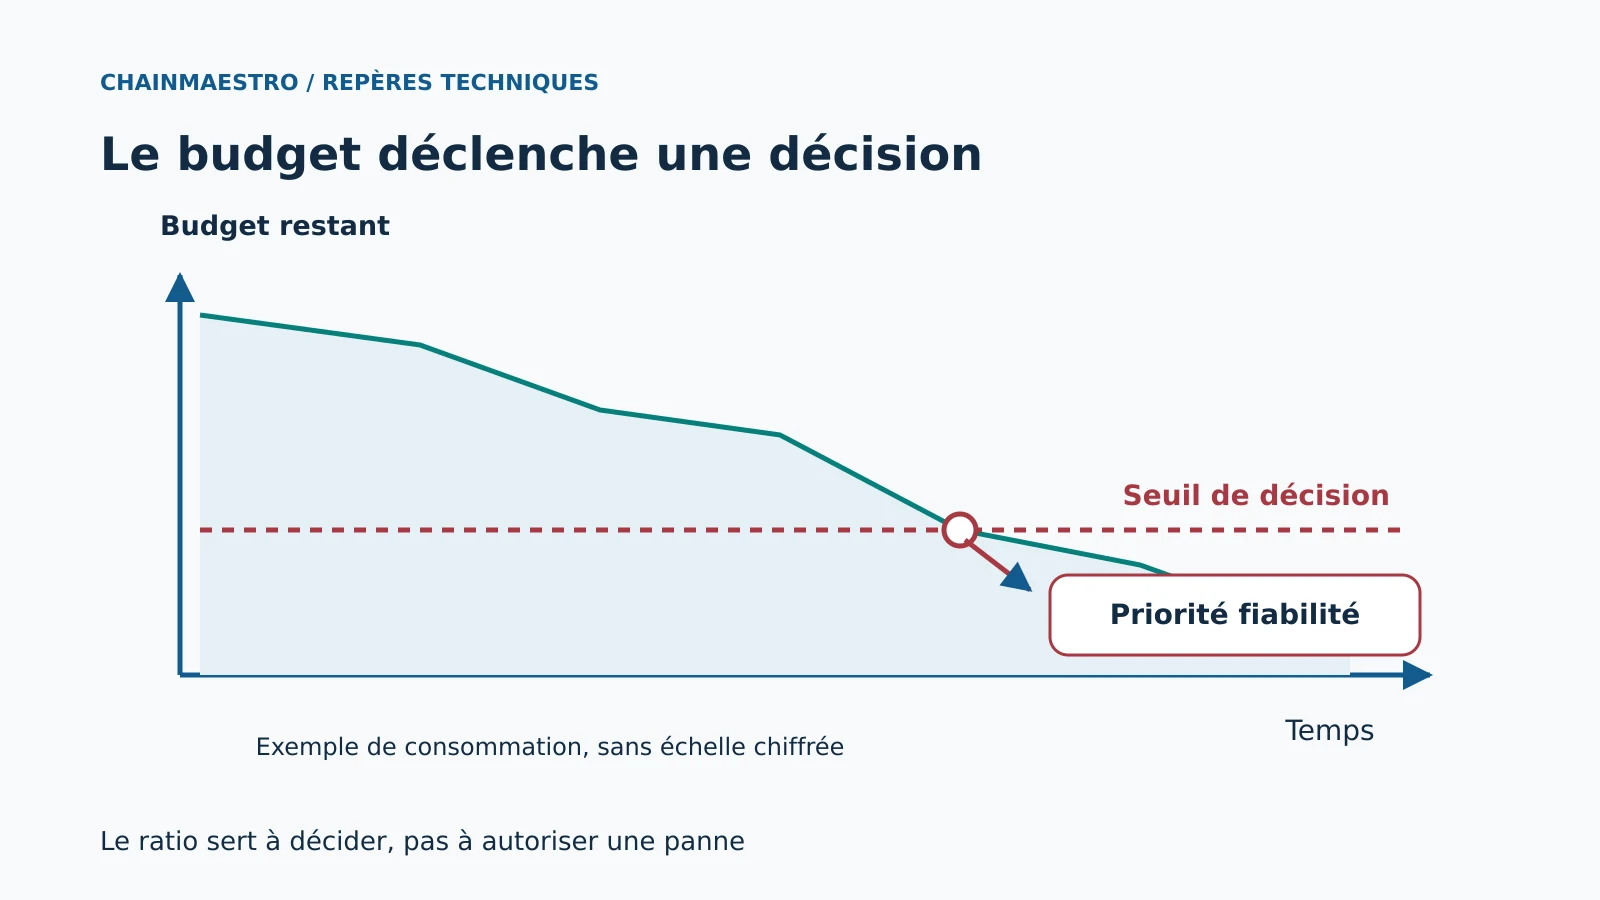
| Action | Priorité fiabilité à un seuil convenu | Transforme le graphique en décision |
Observer la vitesse de consommation
Attendre l’épuisement total du budget peut laisser une panne durer trop longtemps. Le taux de consommation, parfois appelé burn rate, compare la vitesse d’échec à celle compatible avec l’objectif. Une dégradation très rapide demande une réaction immédiate ; une dérive lente peut nécessiter une action planifiée. Plusieurs fenêtres aident à distinguer une pointe brève d’un problème persistant.
Les seuils doivent correspondre à une action possible. Réveiller une astreinte pour un signal sans diagnostic ni levier crée de la fatigue. Une alerte indique le parcours touché, la mesure, le contexte et le premier contrôle à effectuer. Un tableau plus large explique ensuite la cause probable. Les principes de données décisionnelles restent pertinents : une métrique doit conduire à un choix, avec son périmètre visible.
Les fournisseurs ne retirent pas la responsabilité du parcours
Une API externe peut tomber alors que votre infrastructure fonctionne. L’utilisateur voit néanmoins une tâche inachevée. Le SLO du parcours conserve cet effet, puis les diagnostics distinguent les causes internes et externes. Les contrats fournisseurs et les choix d’intégration servent à définir délais, alternatives et dégradations acceptables.
Une fonction de recommandation peut disparaître temporairement sans bloquer la commande. Un paiement ne peut pas être déclaré réussi par défaut. Les modes de dégradation sont donc spécifiques et testés. Le budget d’erreur aide à prioriser la robustesse de ces frontières ; il ne remplace pas une politique métier sur les résultats incertains.
Commencer avec une promesse limitée et observable
Choisir un parcours important, une mesure disponible et une cible réaliste permet de commencer. Une période d’observation révèle les trous de collecte et les différences entre segments. Le produit et l’exploitation conviennent ensuite d’une politique de décision, avec une date de révision. Il vaut mieux un objectif simple utilisé chaque semaine qu’une douzaine de chiffres jamais consultés.
La prochaine action consiste à écrire sur une page ce qui rend un événement satisfaisant, comment il est compté et quelle action une consommation excessive déclenche. Si ces trois réponses sont partagées par l’équipe, le SLO devient un outil de travail.
Sources et références
Mise à jour du 1er octobre 2026 : références vérifiées à cette date. Les mécanismes décrits sont durables ; les options exactes restent à vérifier dans la version du produit utilisée.
- Google — The Site Reliability Workbook, Implementing SLOs (2018) — définition des indicateurs et objectifs de service
- Google — Error Budget Policy (2018) — lien entre budget et décisions de livraison