Ce qu’il faut retenir
- Une identité temporaire limite la durée de validité d’un accès, mais sa portée doit aussi être restreinte.
- Le fournisseur cloud doit vérifier quel dépôt, quel contexte et quel workflow peuvent obtenir un rôle.
- Un job compromis peut agir pendant la durée de son accès : runner, dépendances et environnement restent à protéger.
Une clé cloud a été créée pour un déploiement, copiée dans la CI, puis réutilisée par plusieurs projets. Des mois plus tard, personne ne sait précisément quels jobs en dépendent. Sa rotation devient risquée et sa fuite donne un accès durable. Le problème peut se traiter en changeant le modèle : le job prouve son identité au fournisseur, qui lui accorde un jeton temporaire au lieu de lui confier une clé permanente.
La confiance remplace la copie d’un secret
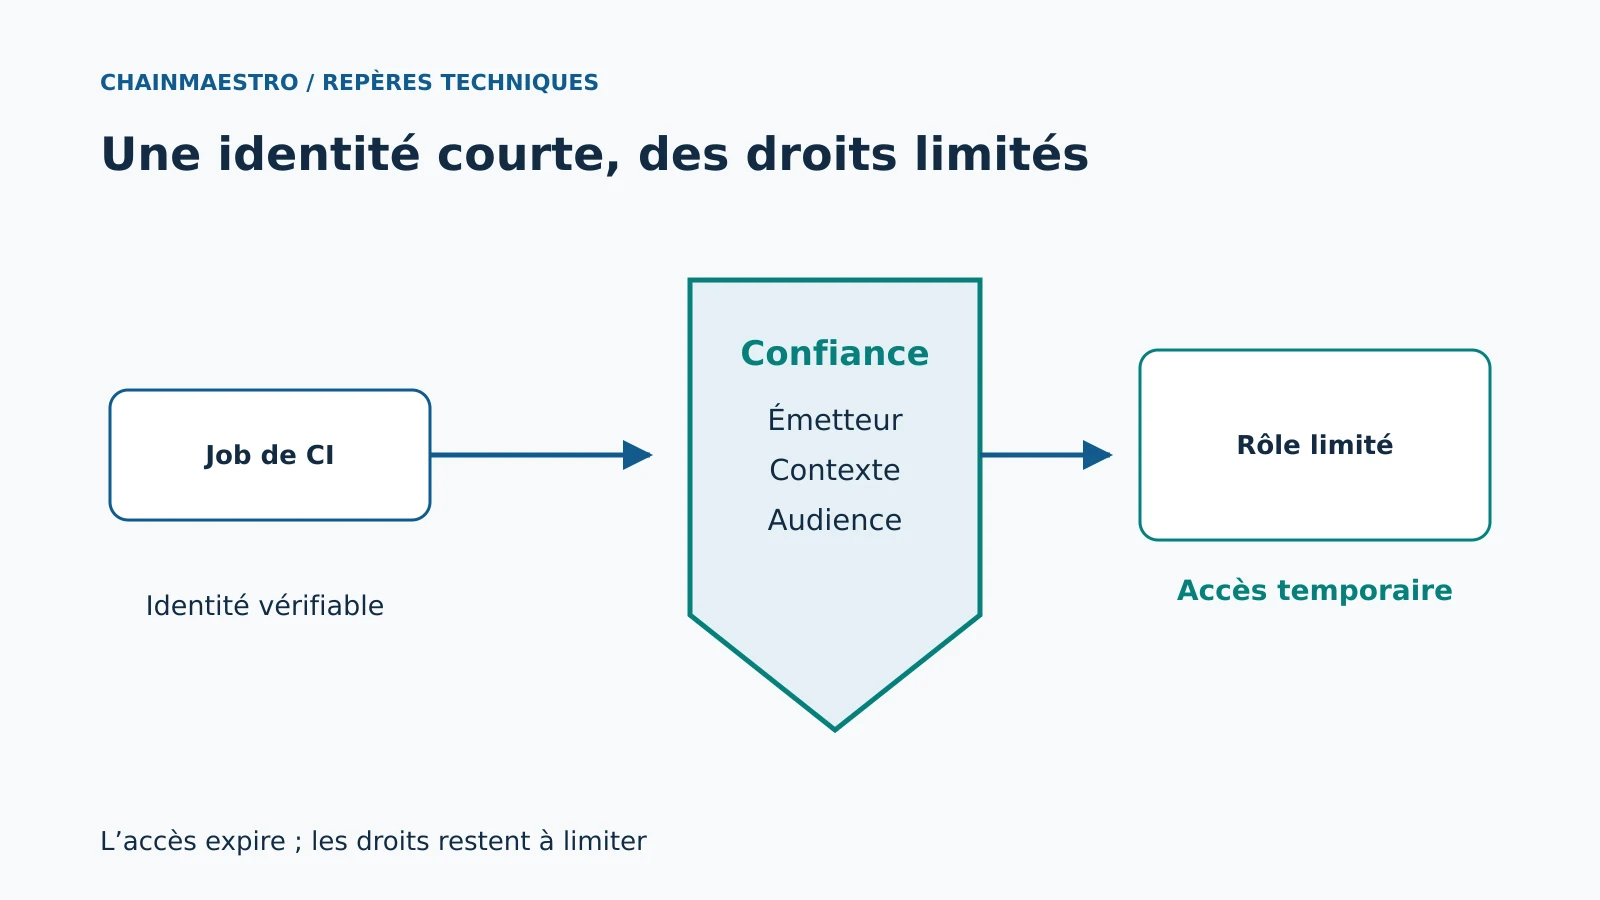
OpenID Connect, ou OIDC, permet d’échanger une preuve d’identité du workflow contre un accès court auprès d’un service compatible. La documentation GitHub Actions décrit cette relation entre plateforme de CI et fournisseur cloud. Le jeton d’identité contient des attributs que le destinataire vérifie avant d’émettre des droits. L’identité du job et les autorisations qu’il reçoit sont deux décisions distinctes.
L’avantage tient à la disparition d’une clé cloud de longue durée du coffre de la CI. Il ne faut pas en déduire qu’aucun secret n’existe plus dans le système. Un fournisseur tiers peut encore exiger une clé API. Une application possède ses propres credentials. Chaque accès est inventorié et traité selon le mécanisme réellement disponible ; une migration OIDC n’efface pas les dépendances restantes.
Cette granularité rejoint le principe développé dans notre dossier sur les agents et la sécurité : une identité prouvée ne devrait recevoir que les actions nécessaires à sa mission. Un job chargé d’envoyer une image au registre n’a pas besoin de lire la base clients ni de modifier la politique de comptes cloud.
Écrire une politique de confiance étroite
Le fournisseur doit accepter l’émetteur attendu, l’audience prévue et les attributs correspondant au contexte autorisé. Faire confiance à toute la plateforme de CI ouvre un périmètre beaucoup trop large. Le sujet du jeton, les informations du dépôt et du workflow, ainsi que l’environnement, servent à limiter la relation selon les possibilités du fournisseur. Les formats précis évoluent : les recopier depuis un exemple ancien sans les vérifier peut autoriser le mauvais contexte ou bloquer le bon.
Une branche dite « production » reste une règle utile seulement si son accès est protégé. Il faut examiner qui peut modifier le workflow, déclencher une exécution, approuver l’environnement ou réutiliser un job. Un acteur capable de changer le code exécuté par un rôle de production dispose indirectement de ce rôle. La revue des règles de dépôt appartient donc à la conception de la confiance.
Distinguer publier et déployer
Le rôle de build construit l’artefact. Le rôle de publication écrit dans un espace limité du registre. Le rôle de déploiement met à jour un service ou un environnement précis. Cette séparation évite d’accorder au travail de compilation les droits nécessaires à la production. Elle réduit aussi le rayon d’impact d’une dépendance malveillante exécutée pendant le build.
La durée accordée suit la durée utile de l’opération, avec les contraintes du fournisseur. Un jeton court ne rend pas acceptable un rôle administrateur. Pendant quelques minutes, un droit de suppression ou de création d’identité reste dangereux. L’autorisation doit donc être testée par ce qu’elle permet et ce qu’elle refuse, au-delà de sa date d’expiration.
Un déploiement de documentation ne doit pas ouvrir le cloud
Exemple hypothétique : une équipe possède un dépôt d’application et un dépôt de documentation. Les deux publient des fichiers, mais seule l’application peut mettre à jour le service de production. Les jobs obtiennent des rôles différents. Le dépôt de documentation écrit uniquement dans son compartiment de stockage. Une contribution externe à la documentation n’accède à aucune identité de production.
La recette lance un job légitime, puis plusieurs variantes refusées : dépôt voisin, branche de test, environnement différent, workflow non prévu. Elle tente également une action hors périmètre avec un jeton valide. Un refus à l’authentification ne teste pas le même contrôle qu’un refus d’autorisation ; les deux preuves sont nécessaires. Les journaux associent le rôle obtenu à l’exécution sans enregistrer les jetons eux-mêmes.
La grille de confiance d’un job
| Dimension | Question à poser | Vérification |
|---|---|---|
| Émetteur | Qui signe l’identité ? | Plateforme et clés attendues |
| Contexte | Quel job peut obtenir le rôle ? | Dépôt, workflow et environnement autorisés |
| Portée | Que peut faire le jeton ? | Actions et ressources limitées |
| Temps | Combien de temps l’accès est-il utile ? | Expiration et comportement après échéance |
La durée courte ne nettoie pas le runner
Un runner compromis peut utiliser le jeton au moment où il est présent. Une action tierce peut recevoir plus d’accès que prévu si les permissions du job sont trop larges. Un cache de build peut réintroduire un fichier dangereux. Une identité courte réduit la persistance d’un secret exfiltré, mais ne remplace pas l’isolement des exécutions, la revue des actions et l’intégrité des artefacts.
Les logs de débogage sont une autre voie de fuite. Le masquage automatique d’un secret connu est un filet, pas une autorisation à imprimer les variables. Les jetons doivent rester dans le chemin d’authentification nécessaire, avec le moins d’étapes capables de les lire. Un artefact d’échec ou un dump mémoire peut aussi contenir des informations sensibles ; sa conservation suit une politique explicite.
Les intégrations entre outils multiplient les frontières de confiance. Une étape qui télécharge un script et l’exécute avant le déploiement devient un acteur de cette chaîne. Épingler une dépendance réduit l’incertitude sur ce qui est exécuté ; vérifier sa provenance et sa maintenance traite une autre partie du risque.
Migrer sans laisser la vieille clé en secours permanent
Commencer par un job limité permet de valider le fournisseur, les attributs et les refus attendus. Le nouveau parcours est observé sur des exécutions réelles. Ensuite, la clé durable est désactivée, les appels restants sont identifiés et la procédure d’incident mise à jour. Garder indéfiniment l’ancien secret « au cas où » laisse intact le risque que la migration devait réduire.
Un secours peut être nécessaire, mais il a un propriétaire, un usage exceptionnel et une durée. Il ne se confond pas avec un accès ordinaire caché dans un second coffre. Le plan de retour explique comment restaurer un déploiement fonctionnel sans réintroduire un compte partagé tout puissant. Les essais doivent être suffisamment isolés pour ne pas modifier la production simplement afin de prouver un accès.
Mesurer les droits qui disparaissent
Un inventaire suit les clés durables restantes, les rôles obtenus temporairement et les jobs pouvant les demander. Le délai de rotation et les refus d’accès inattendus éclairent la maintenance. Le coût de gestion entre dans le coût réel de l’infrastructure : réduire les secrets partagés peut simplifier les opérations, à condition que la politique de confiance soit lisible.
La prochaine étape utile consiste à choisir une clé de déploiement partagée, à tracer ses utilisateurs puis à concevoir un rôle temporaire pour une seule opération. La réussite se constate lorsque le job fonctionne avec ce rôle, que les contextes voisins sont refusés et que l’ancienne clé ne sert plus.
Sources et références
Mise à jour du 1er octobre 2026 : références vérifiées à cette date. Les mécanismes décrits sont durables ; les options exactes restent à vérifier dans la version du produit utilisée.
- GitHub Actions — OpenID Connect — échange de jetons et contrôle des attributs du workflow
- SLSA 1.0 — Provenance — traçabilité des artefacts et identité de fabrication