Ce qu’il faut retenir
- Un routeur choisit quel modèle traite une demande. Son intérêt dépend du coût complet et de la qualité de la tâche obtenue.
- La difficulté estimée, le risque métier et les contraintes de données doivent être distingués.
- Le routage exige sa propre recette : mauvaises orientations, reprises, échecs des fournisseurs et retour à une route stable.
Sources vérifiées le 1er octobre 2026. Aucun tarif fournisseur ni résultat d’économie propre à une entreprise n’est présumé.
Faire traiter toutes les demandes par le modèle le plus coûteux paraît simple. Les envoyer toutes au moins coûteux peut reporter la dépense sur les corrections. Entre les deux, le routage promet d’adapter le calcul à la tâche. La promesse tient seulement si le système identifie assez bien les cas qui nécessitent plus de capacité et mesure ce qui se passe après la première réponse.
Ce qu’un routeur décide
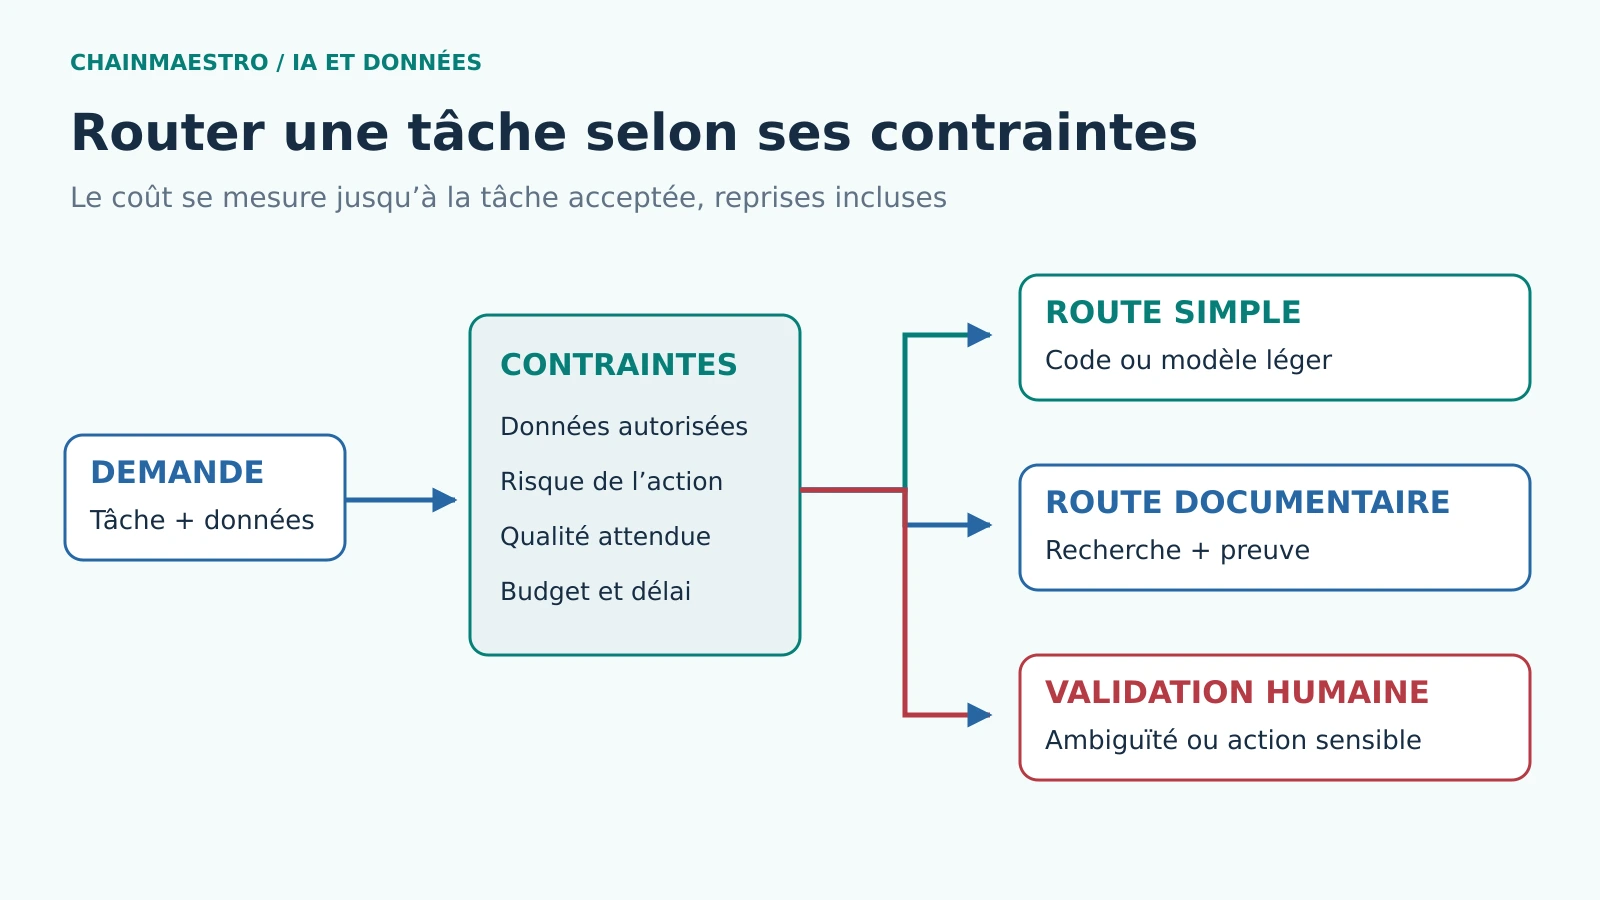
Un routeur reçoit une demande, observe certains signaux et choisit une destination. Il peut utiliser des règles explicites, un classifieur ou un modèle qui estime la difficulté. La destination peut être un modèle, une chaîne documentaire ou une file humaine. Il est souvent plus utile de router entre modes de traitement que d’opposer seulement un petit et un grand modèle.
Le travail RouteLLM étudie des routeurs appris à partir de préférences pour arbitrer entre modèles. Il montre la possibilité de cet arbitrage dans ses conditions expérimentales. Ses résultats ne constituent ni un budget prévisionnel pour un autre produit ni une garantie de qualité sur un corpus métier différent.
Une demande courte peut être sensible. « Révoque cet accès » comporte peu de texte, mais déclenche une action. Une demande longue peut être banale, par exemple reformater un document public. La longueur, le nombre de jetons et un score de confiance ne doivent donc pas être confondus avec le risque. Les contraintes de données s’appliquent avant la préférence économique.
Commencer par une carte des tâches
| Famille | Route possible | Critère de contrôle |
|---|---|---|
| Transformation simple | Modèle léger ou code déterministe | Respect du format et conservation des informations |
| Question documentaire | Recherche puis génération encadrée | Preuve pertinente et affirmation soutenue |
| Demande ambiguë | Clarification | Information manquante identifiée avant action |
| Action sensible | Contrôles et validation du processus | Objet, autorisation et résultat vérifiés |
| Données confinées | Route compatible avec le périmètre | Destinations et conservation conformes à la politique |
La carte peut être testée avec des règles simples. Un routeur appris ajoute une couche de maintenance : données d’entraînement, stabilité, explicabilité suffisante pour le diagnostic et dépendance à sa propre version. Le système le plus complexe n’est pas automatiquement le plus économique. Une séparation nette entre tâches peut offrir un meilleur résultat qu’une estimation subtile de difficulté.
Le dossier sur les usages IA des équipes fournit un point de départ pour inventorier les tâches. Chacune doit recevoir un critère de qualité propre. Une note globale de satisfaction ne peut pas valider à la fois un résumé, une extraction et une action sur le système de gestion.
Compter les reprises dans l’économie annoncée
Le coût d’une tâche achevée comprend classification, appels aux modèles, recherche, validation, nouvelles tentatives et intervention humaine. Les jetons d’entrée et de sortie dépendent de la route ; un modèle qui demande plusieurs essais peut coûter davantage qu’un modèle plus cher qui réussit directement. Les réponses longues augmentent aussi la dépense sans toujours augmenter la valeur.
Un calcul interne peut utiliser la relation suivante : coût moyen par tâche acceptée = dépenses attribuables à la période divisées par nombre de tâches acceptées selon la recette. Conserver aussi le coût des tâches rejetées et leur volume. Si elles disparaissent du tableau, le produit peut sembler efficace parce qu’il renvoie les difficultés aux équipes.
Cette mesure complète le coût réel des modèles, API et infrastructures. Elle doit distinguer économies constatées et projections. Pour une projection, écrire les hypothèses de trafic, de reprises et de disponibilité. Faire varier ces hypothèses montre souvent que l’incertitude sur les corrections dépasse la différence de prix du premier appel.
Le routeur a besoin d’une vérité de référence
Construire un lot de demandes avec catégories, sorties attendues et erreurs coûteuses. Pour chaque cas, évaluer les destinations envisagées sur les mêmes entrées. Le routeur peut alors être jugé sur la route choisie et le résultat final. Une orientation économiquement avantageuse mais incompatible avec les données compte comme un échec, quelle que soit la qualité rédactionnelle de la réponse.
La difficulté doit être définie par la performance observée sur la tâche, pas par le sentiment d’un modèle sur ses capacités. Une confiance déclarée peut servir de signal après calibration ; elle n’a pas une signification universelle. Les métriques par famille et les effectifs empêchent la moyenne d’écraser les catégories moins fréquentes.
La documentation scikit-learn sur les fuites de données rappelle l’importance de séparer développement et test. Le routeur, les consignes et les critères de sélection doivent être ajustés sans consulter indéfiniment le lot final. Sinon, on mesure surtout une adaptation aux exemples connus.
La cascade : utile, mais pas gratuite
Une cascade commence avec une route légère, valide la réponse, puis escalade si nécessaire. Elle exige un contrôle capable de repérer les défauts intéressants. Un simple JSON valide permet de détecter certaines erreurs de format, mais laisse passer un montant faux. Un vérificateur documentaire peut manquer une exception. L’escalade ne fonctionne que dans la mesure où ces contrôles savent identifier les erreurs.
La latence de bout en bout inclut les appels successifs. Définir un délai limite et un nombre de tentatives évite les boucles coûteuses. Une nouvelle tentative ne doit pas répéter une action déjà exécutée : pour les outils, conserver l’état et une clé d’idempotence adaptée. Un routeur de texte peut rejouer une génération ; un routeur d’actions doit d’abord réconcilier le résultat.
Les agents reliés aux outils par MCP renforcent cette distinction. Changer de modèle ne retire pas les effets de l’appel précédent. La chaîne doit savoir si elle a seulement produit une proposition ou réellement modifié une donnée, avant d’autoriser une reprise.
Un routeur de support avec une exception de sécurité
Scénario hypothétique. Un éditeur distingue reformulation d’un message, réponse issue de sa documentation et demande de modification d’un compte. La première route utilise une solution légère, la deuxième une recherche avec preuve, la troisième une procédure d’autorisation. Une alerte de compromission suit un circuit spécialisé, même si son texte ressemble à une demande de mot de passe oublié.
La recette mesure la qualité de chaque famille, les mauvaises orientations et les tâches reprises manuellement. Un mode d’observation fait calculer le choix du routeur sans modifier la route réellement utilisée. L’équipe compare ainsi ses propositions à la référence et inspecte les cas de désaccord avant de lui confier une part du trafic.
L’activation progressive garde une route de secours connue. Si un fournisseur échoue, la destination de repli doit respecter le même périmètre de données et les critères de qualité. Une bascule vers un service externe ne devient pas autorisée parce que le service interne est indisponible. Les demandes sensibles peuvent attendre ou rejoindre la file humaine.
Les quatre indicateurs à lire ensemble
- Qualité par famille. Résultats acceptés, erreurs critiques et abstentions appropriées.
- Coût par tâche achevée. Tous les appels et reprises, avec les hypothèses d’attribution.
- Délai de bout en bout. Temps médian et percentiles élevés, sans retirer les timeouts.
- Stabilité des routes. Part des orientations et changements après mise à jour ou variation du trafic.
Une dérive des routes peut signaler un changement de demandes, une erreur de classification ou une modification du fournisseur. Elle n’est pas nécessairement une amélioration. Conserver les versions et quelques cas représentatifs permet de trouver la cause. Le retour à une route fixe doit rester techniquement possible lorsque le diagnostic n’est pas encore établi.
Sources et références
Sources primaires consultées le 1er octobre 2026 : RouteLLM, Ong et collaborateurs ; scikit-learn, erreurs courantes et fuites. La grille de routage, les formules de suivi et le scénario sont des recommandations ; aucune économie chiffrée universelle n’en est déduite.