Ce qu’il faut retenir
- Le bon indicateur est le temps nécessaire pour retrouver une application utilisable, avec des données cohérentes.
- Un export logique et une sauvegarde physique avec journaux répondent à des besoins différents. Leur procédure de restauration ne se mélange pas.
- Un exercice isolé doit vérifier les accès, les pièces jointes, les intégrations et les opérations métier, au-delà du démarrage de PostgreSQL.
Le tableau de bord annonce une sauvegarde terminée. Puis une migration efface une colonne utile, un opérateur supprime des lignes ou un compte compromis altère des commandes. La question change immédiatement : quel état peut-on retrouver, en combien de temps et avec quelles pertes ? La réponse se prépare avant cet incident. Un fichier présent dans un stockage objet est une pièce du dispositif, pas sa démonstration.
Commencer par deux engagements concrets
Le RPO, objectif de point de reprise, exprime la quantité de données que l’entreprise accepte de perdre, souvent sous forme d’une durée. Le RTO, objectif de temps de reprise, fixe le délai acceptable pour rétablir le service. Une boutique peut tolérer dix minutes d’indisponibilité pour son catalogue tout en refusant la perte d’un paiement. Ces exigences imposent des traitements différents selon les données, même dans une base unique.
Dans un exemple hypothétique, un SaaS de réservation vise un RPO de cinq minutes et un RTO d’une heure. Un export nocturne seul ne satisfait pas le premier objectif. Un archivage continu des journaux peut rapprocher la reprise du moment de l’incident, mais le temps pour provisionner la machine, télécharger la sauvegarde et rejouer les changements doit encore tenir dans la deuxième limite. Ces valeurs sont des choix d’entreprise, pas des garanties fournies par PostgreSQL.
Attribuer un responsable à chaque étape évite les minutes perdues à chercher qui possède la clé de chiffrement ou le compte de stockage. Le budget se compare au coût d’une interruption, avec le même souci de mesure que dans notre analyse des coûts d’API et d’infrastructure. La sauvegarde bon marché dont la restauration exige deux jours de travail reste coûteuse au moment critique.
Choisir la chaîne de restauration, pas seulement le fichier
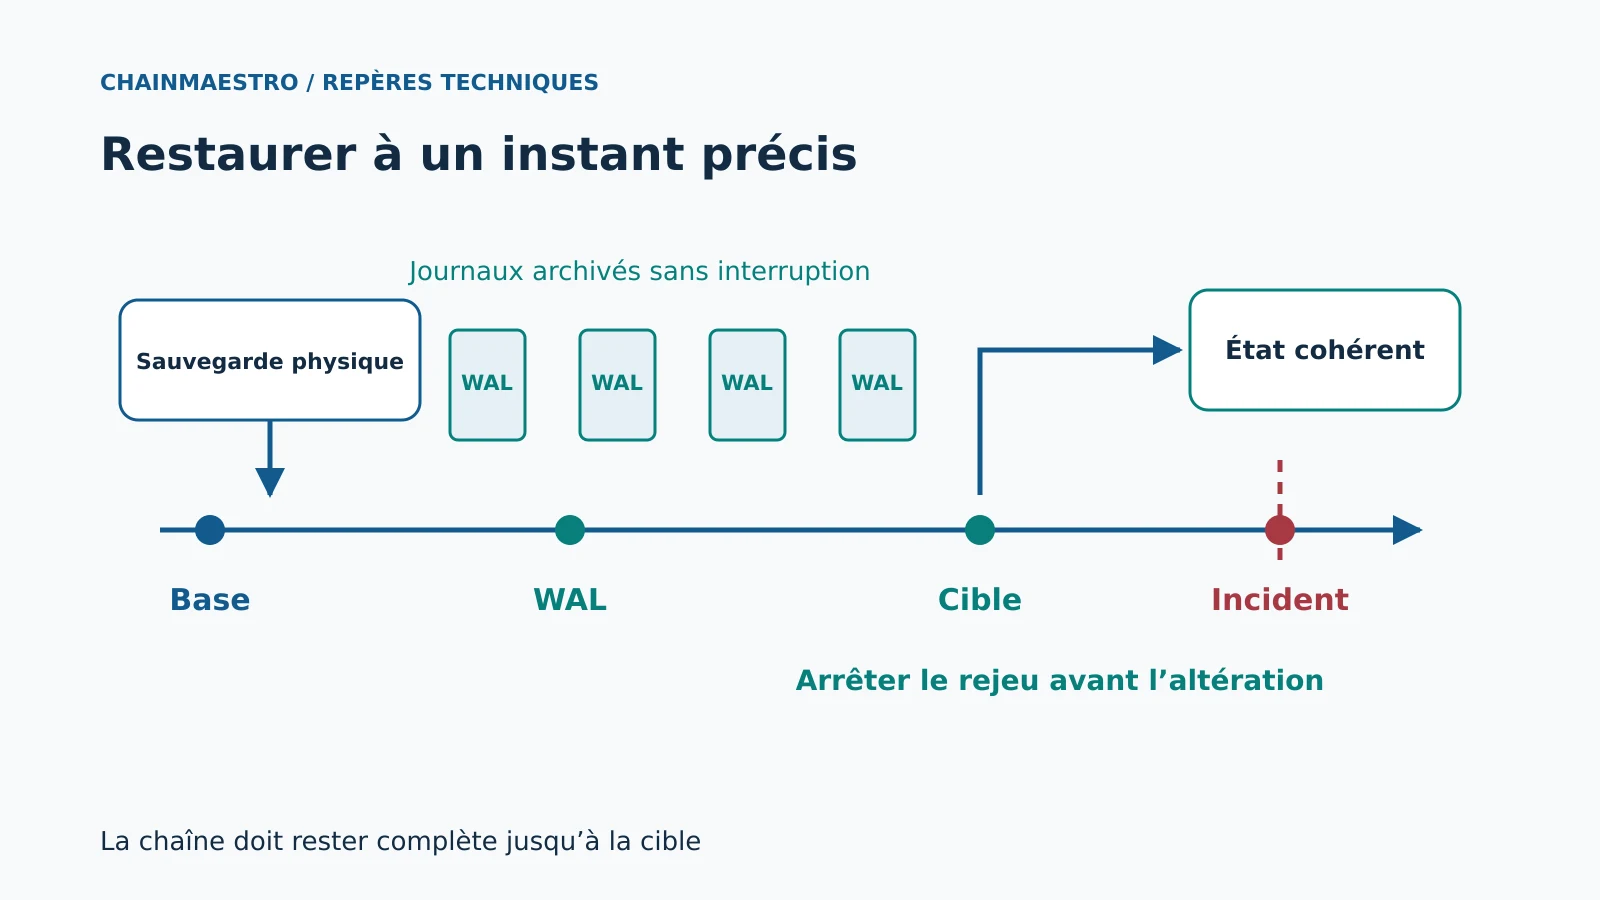
La documentation PostgreSQL 17 distingue trois approches : export SQL, sauvegarde du système de fichiers et archivage continu. Pour un petit service, un export logique facilite la restauration d’objets et la portabilité. Pour une reprise à un instant précis, une sauvegarde physique de base et une suite continue de journaux WAL constituent une autre chaîne. WAL signifie journal d’écriture anticipée : il conserve les changements nécessaires au rejeu.
Un export pg_dump ne devient pas une sauvegarde physique en lui ajoutant des WAL. Il faut choisir une procédure cohérente de bout en bout. Une copie naïve du répertoire d’une base active peut être inutilisable si elle ne respecte pas les mécanismes de sauvegarde. Un réplica suit les modifications du primaire : il peut donc propager une suppression accidentelle. Il sert la disponibilité mais ne remplace pas un historique de récupération.
Trois questions pour choisir une stratégie
| Besoin | Approche à étudier | Preuve à obtenir |
|---|---|---|
| Restaurer un ensemble limité d’objets | Export logique | Objets, dépendances et droits reconstruits |
| Revenir juste avant une altération | Sauvegarde physique et WAL | Chaîne continue et cible de reprise contrôlée |
| Résister à la perte d’un serveur | Copie indépendante et procédure de reprise | Accès possible sans le serveur perdu |
Un exercice qui reconstruit un service complet
L’exercice se déroule sur une infrastructure isolée de la production. Le compte utilisé lit les sauvegardes et ne peut pas écraser l’instance active. Les connexions sortantes vers le paiement, les notifications et les webhooks sont neutralisées : un environnement restauré peut rejouer des tâches et produire de vrais effets externes. Pour les données sensibles, l’environnement de test reçoit les mêmes règles d’accès et de conservation que les sauvegardes elles-mêmes.
- Choisir une sauvegarde et un instant cible, puis noter l’état métier attendu à cette date.
- Reconstituer la machine, les extensions nécessaires et les paramètres indispensables.
- Restaurer les données selon la procédure choisie, en enregistrant début, fin et erreurs.
- Connecter une version compatible de l’application, avec ses tâches asynchrones désactivées.
- Exécuter des lectures métier et une écriture de test réversible dans l’environnement isolé.
- Confronter les résultats aux objectifs et consigner les étapes manuelles restantes.
Dans le SaaS de réservation, une requête qui compte les lignes ne suffit pas. Le test consulte une réservation antérieure à la cible, vérifie son client, sa facture, la pièce jointe et les permissions. Il confirme aussi qu’une réservation postérieure à la cible est absente. Un contrôle de cohérence rapproche les totaux et les références selon les règles du produit. Cette liste dépend du service ; elle doit rester assez courte pour être rejouée régulièrement.
Ce que la base ne ramène pas seule
Les fichiers stockés hors PostgreSQL, les configurations, les certificats et les clés sont des dépendances de reprise. Leur historique doit être compatible avec l’état de la base. Restaurer une référence vers une image disparue laisse une application cassée malgré un SQL parfaitement cohérent. Le même principe vaut pour les index de recherche : prévoir leur reconstruction peut être plus fiable que chercher à les sauvegarder au même instant.
Les intégrations API ajoutent un problème de réconciliation. Un paiement traité par un fournisseur après l’instant cible n’est pas annulé parce que la base locale revient en arrière. L’application doit rapprocher les événements externes et les identifiants persistants avant de reprendre les effets métier. C’est un point de contrôle humain explicite, pas une reprise aveugle des files.
Surveiller les maillons qui cassent en silence
Une chaîne de journaux incomplète peut empêcher d’atteindre l’instant voulu. Surveiller l’âge du dernier segment effectivement archivé, les échecs, l’espace disponible et la durée des sauvegardes apporte une alerte avant la catastrophe. Mesurer seulement l’exécution du cron donne une preuve faible : le processus peut démarrer et échouer ensuite, ou écrire dans le mauvais stockage.
Tester la lecture depuis le site de reprise détecte les erreurs de permissions et de chiffrement que le serveur source ne voit pas. Une rotation de clé doit préserver la capacité à lire les anciennes sauvegardes encore retenues. La politique de rétention doit garder tous les éléments nécessaires à chaque point de restauration annoncé ; supprimer un élément d’une chaîne sans vérifier les dépendances invalide sa promesse.
Une copie indépendante des identités de production réduit l’impact d’un compromis. Le responsable sécurité vérifie qui peut supprimer les sauvegardes, modifier la rétention et obtenir les clés. Ces droits doivent être plus restreints que les droits usuels de déploiement. Les principes de limitation des actions décrits dans notre dossier sur la cybersécurité des agents s’appliquent aussi aux outils de sauvegarde.
Le critère de réussite tient sur une fiche
Une fiche d’exercice contient la sauvegarde choisie, l’instant atteint, les versions utilisées, la perte observée, les durées par étape et les contrôles métier. Elle identifie aussi les dépendances absentes et les opérations externes à réconcilier. Le résultat est accepté seulement si le service utilisable respecte le RTO et si la perte mesurée respecte le RPO. Un succès partiel doit porter ce nom.
La fréquence des exercices suit le rythme du changement : nouveau stockage, extension, version majeure, mode de chiffrement ou augmentation forte du volume justifient une nouvelle preuve. Entre ces événements, un calendrier régulier évite que la procédure ne devienne une archive théorique. La prochaine action utile consiste à restaurer une sauvegarde récente sur un environnement isolé et à chronométrer la reprise réelle.
Sources et références
Mise à jour du 1er octobre 2026 : références vérifiées à cette date. Les mécanismes décrits sont durables ; les options exactes restent à vérifier dans la version du produit utilisée.
- PostgreSQL 17 — Backup and Restore — typologie des sauvegardes
- PostgreSQL 17 — Continuous Archiving and PITR — chaîne physique, WAL et reprise à un instant
- PostgreSQL 17 — SQL Dump — périmètre des exports logiques