Ce qu’il faut retenir
- Un PDF lisible et un champ exact sont deux résultats différents. Les montants, dates et identifiants exigent une mesure propre.
- La recette doit distinguer PDF natif, scan et fichier mixte, puis mesurer les erreurs sur les documents réellement reçus.
- Conserver la page et la zone d’origine permet de vérifier une valeur et de traiter les ambiguïtés avant toute action.
Mise à jour du 1er octobre 2026 : documentation vérifiée à cette date.
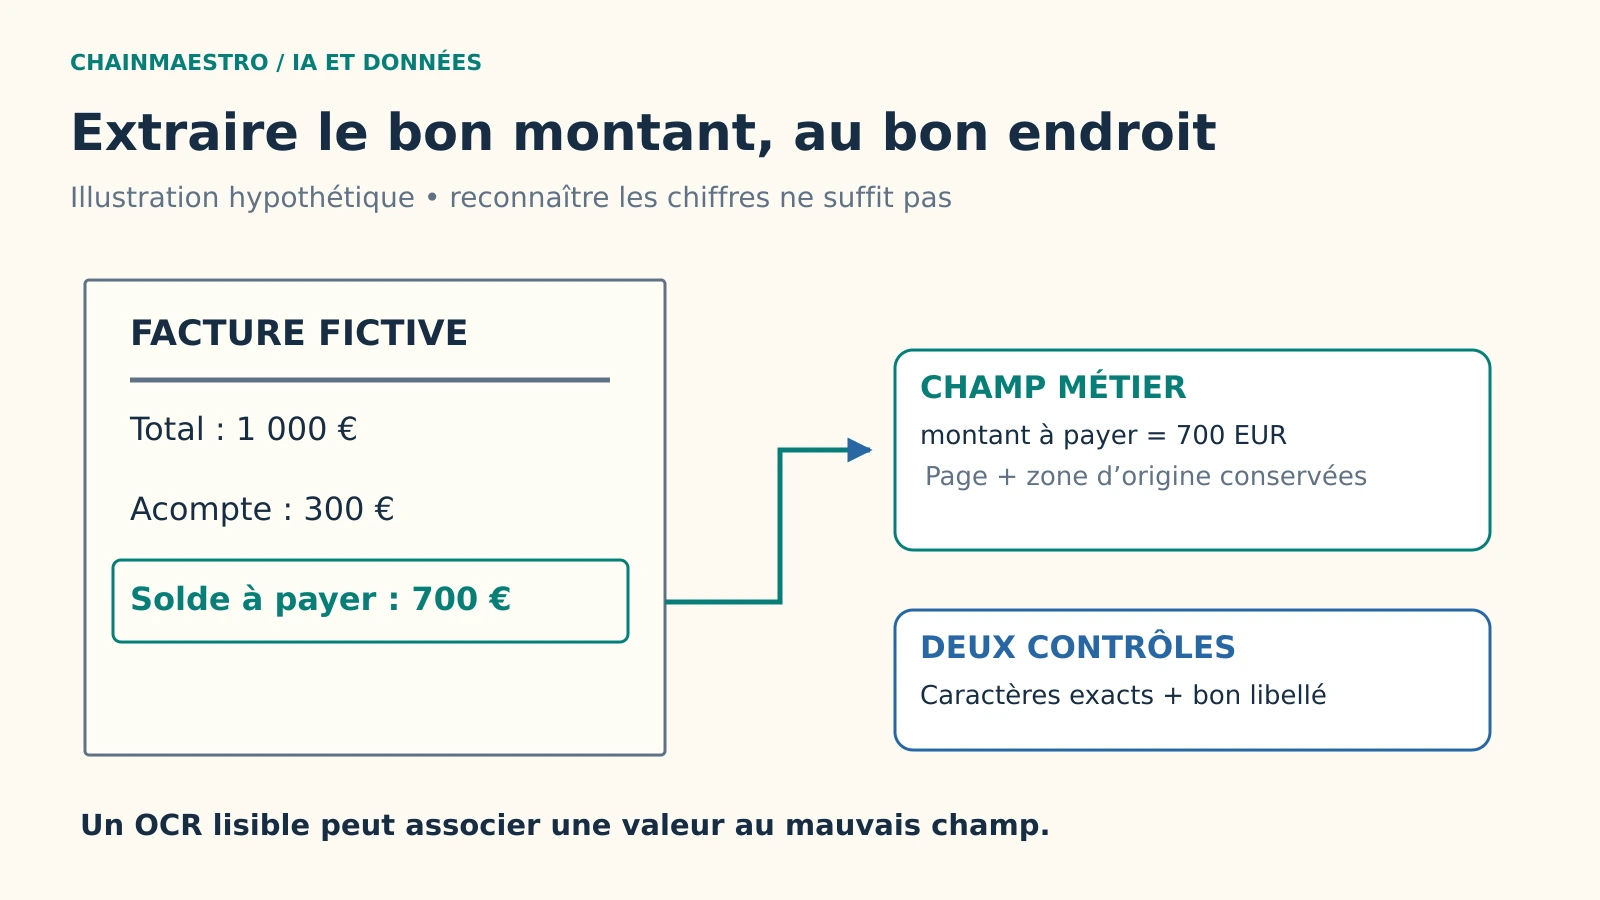
Une facture extraite paraît correcte à l’écran. Le fournisseur, la date et les lignes sont présents. Le total contient pourtant un chiffre erroné, ou le montant hors taxes a été pris pour le montant à payer. Un contrôle qui mesure seulement la proportion de caractères reconnus peut déclarer cette sortie excellente. L’équipe comptable, elle, doit savoir si la valeur utilisée dans le processus est la bonne.
Trois entrées qui ne demandent pas le même traitement
Un PDF natif peut contenir du texte directement récupérable. Un scan contient surtout des images et requiert une reconnaissance optique de caractères, ou OCR. Un fichier mixte associe les deux, parfois avec une ancienne couche de texte incorrecte. Inspecter un échantillon évite d’appliquer un OCR à tout le lot ou de faire confiance à une extraction native dont l’ordre de lecture est incohérent.
La documentation Tesseract sur la qualité de reconnaissance souligne l’effet de la résolution, du bruit, de l’inclinaison et de la segmentation. Ces facteurs orientent les essais de préparation d’image. Ils ne constituent pas une promesse d’exactitude pour un document métier, et améliorer l’image ne corrige pas automatiquement l’association entre une valeur et son libellé.
L’ordre de lecture est une difficulté distincte. Sur une facture à deux colonnes, les mots peuvent être tous reconnus mais réunis dans le mauvais ordre. Dans un tableau, un montant correct peut rejoindre la mauvaise ligne. Le système doit donc conserver les positions et la structure lorsque le cas d’usage en dépend, plutôt que réduire prématurément toute la page à une chaîne de caractères.
Définir exactement ce que l’on veut extraire
Le dictionnaire des champs précise nom, type, unité, règle de normalisation et état possible. Une date ambiguë doit rester ambiguë si le contexte ne tranche pas. Une référence contient parfois des zéros initiaux : la convertir en entier peut perdre de l’information même lorsque l’OCR n’a commis aucune erreur. Un montant nécessite une devise et une indication du rôle de la valeur.
Prévoir séparément « absent », « illisible », « plusieurs valeurs possibles » et « non applicable ». Remplacer tout cela par une chaîne vide prive les opérations d’une information essentielle. Un modèle qui invente une valeur plausible pour remplir le schéma fait pire qu’un modèle qui signale un doute ; la procédure doit récompenser la fidélité à la pièce plutôt que le remplissage.
| Champ | Comparaison pertinente | Erreur à préserver |
|---|---|---|
| Montant à payer | Valeur normalisée, devise et libellé | Confusion avec acompte ou montant hors taxes |
| Date d’échéance | Date interprétée et texte original | Confusion avec la date d’émission |
| Référence | Correspondance exacte selon convention définie | Zéro initial ou caractère voisin perdu |
| Ligne de tableau | Valeurs et association à la bonne ligne | Décalage entre description et prix |
| Absence | Signalement correct de l’absence | Valeur inventée pour compléter la sortie |
La sortie peut suivre un schéma technique, mais ses types ne prouvent pas son contenu. La validation métier vérifie des relations : total cohérent, période plausible, identifiant au bon endroit. Un contrôle de somme est utile sans être une preuve suffisante ; deux erreurs qui se compensent peuvent satisfaire une égalité. Garder le passage ou la zone qui justifie chaque valeur.
Construire une vérité de référence relisible
Prélever des documents par famille, fournisseur, qualité d’image et langue. Ajouter les cas qui perturbent réellement le traitement : photographies de travers, duplicatas, avoirs, pages manquantes, tableaux multipages et pièces jointes contenant plusieurs factures. Séparer les documents proches entre développement et test. Deux versions du même modèle de facture ne doivent pas donner l’illusion de cas indépendants.
Deux lecteurs peuvent annoter un sous-ensemble puis comparer leurs divergences. Lorsqu’ils ne savent pas choisir entre deux dates, il faut définir une règle ou conserver l’ambiguïté. La référence doit inclure la zone de preuve, pas seulement un fichier de valeurs. Les pièces d’origine restent accessibles aux personnes autorisées, avec une durée de conservation définie.
La documentation officielle des métriques aide à distinguer précision et rappel lorsque le système repère des champs. Pour le métier, compléter ces mesures par le taux de document entièrement correct et les erreurs par champ critique. Une moyenne sur tous les champs donne trop de poids aux libellés faciles si la décision dépend d’un seul montant.
La facture qui exige une vérification malgré une bonne reconnaissance
Exemple hypothétique. Une PME reçoit des factures PDF de ses fournisseurs. Le système prépare une fiche comptable avec fournisseur, référence, date d’échéance, montant et devise. Une pièce contient un acompte, un total et un solde. Les trois sommes sont lisibles. L’extraction doit sélectionner le solde à payer selon une règle validée par la comptabilité, puis montrer sa zone d’origine.
La sortie rejoint une file de préparation, sans déclencher de paiement. Un contrôle déterministe vérifie les formats et recherche un doublon ; une personne examine les champs ambigus. Si le fournisseur existe déjà, un rapprochement avec le référentiel évite de créer une nouvelle fiche sur un nom OCR légèrement différent. Une modification de coordonnées bancaires suit un circuit distinct, même si elle est correctement reconnue.
La recette compte les documents transmis sans correction, le temps de correction et les erreurs qui auraient pu traverser le contrôle. Les rejets sont inclus : une chaîne qui accepte les seules pièces faciles peut afficher une précision élevée tout en laissant l’essentiel du travail manuel. Mesurer conjointement couverture, exactitude et effort de vérification donne une décision plus utile.
Modifier une étape à la fois
- Établir une référence simple. Extraction native quand elle est exploitable, OCR pour les pages images, règles explicites pour les champs connus.
- Tester la préparation d’image. Comparer rotation, nettoyage et segmentation sur les mêmes pièces, en gardant les sorties avant et après.
- Tester l’interprétation. Évaluer l’association libellé-valeur et les tableaux indépendamment de la reconnaissance de caractères.
- Tester le recours au modèle. Comparer son aide sur les cas difficiles avec son risque d’inventer des données absentes.
- Rejouer la chaîne complète. Inclure les fichiers corrompus, les délais, les doublons et les refus de traitement dans le bilan.
Une bonne expérience conserve la version de l’OCR, des modèles, du dictionnaire de champs et du code de normalisation. Modifier simultanément ces quatre objets rend le diagnostic inutilement difficile. Les traces enregistrent identifiants, statuts et zones ; elles ne devraient pas recopier toutes les pièces dans un outil d’observabilité ouvert à davantage de personnes.
Le coût d’extraction comprend aussi le stockage, les corrections et les tentatives supplémentaires. Cette lecture prolonge le calcul du coût complet de l’IA. Un traitement plus lourd peut être justifié sur une famille difficile ; l’appliquer à tous les PDF sans mesure peut augmenter la dépense sans améliorer les champs utiles.
Faire passer une preuve jusqu’à l’application métier
Les intégrations API entre outils doivent transmettre l’état du champ et son origine, pas uniquement sa valeur. Un logiciel qui reçoit « 1250 EUR » sans savoir que le champ est ambigu risque de perdre le bénéfice de la recette. Prévoir un statut par champ, une version de pièce et une façon d’ouvrir la preuve.
Le choix d’un traitement local, d’un service hébergé ou d’un logiciel libre se juge sur la famille de documents et le circuit opérationnel. Le dossier sur les modèles et usages open source pour les PME fournit ce contexte de décision. Aucune catégorie de produit ne garantit à elle seule la fidélité des données extraites.
Ce qu’un score de confiance ne résout pas
Un score élevé de reconnaissance ne mesure pas nécessairement la justesse du champ final. Il peut concerner les caractères ou une étape différente de celle qui décide du libellé. Sa valeur doit être confrontée aux erreurs observées sur le lot métier. Les signatures, annotations manuscrites et documents tronqués peuvent requérir un traitement spécifique ou une intervention humaine.
Commencer par les champs qui influencent réellement l’action permet de hiérarchiser le chantier. Une fois leurs erreurs comprises, étendre l’automatisation par famille documentaire, avec une procédure explicite pour les exceptions. Le bon objectif est une donnée vérifiable qui réduit le travail, sans déplacer silencieusement l’incertitude vers le logiciel suivant.
Sources et références
Sources primaires consultées le 1er octobre 2026 : Tesseract, amélioration de la qualité OCR ; scikit-learn, métriques et scores. Les critères d’extraction et le scénario comptable sont des propositions de méthode, sans performance chiffrée revendiquée.