Ce qu’il faut retenir
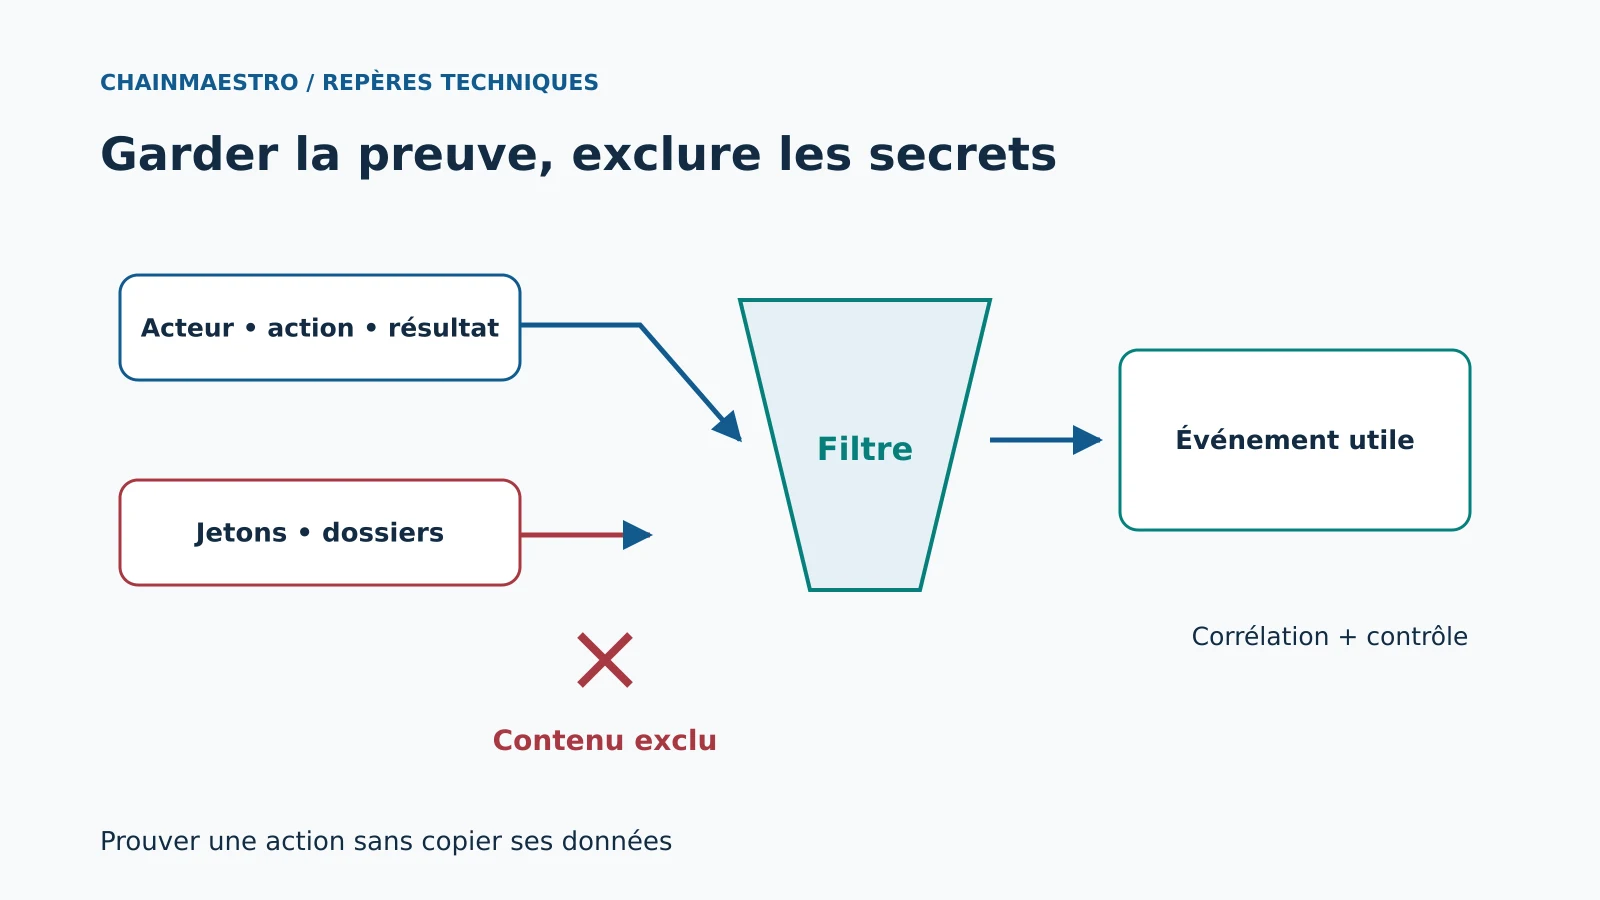
- Un événement structuré apporte souvent une meilleure preuve qu’un corps de requête copié intégralement.
- Mots de passe, jetons et contenus sensibles doivent être exclus à la source, y compris des messages d’erreur.
- La fiabilité des logs dépend aussi des accès, de la collecte, de l’horodatage et de la conservation.
Pour expliquer une erreur, un développeur ajoute le corps complet d’une requête dans les logs. L’incident devient plus facile à reproduire, mais le stockage de journaux contient désormais des adresses, des documents ou des jetons. Ces données circulent ensuite dans des exports et des tickets. Le diagnostic a créé un second système d’information sensible, souvent moins surveillé que la base principale.
Définir ce que l’enquête doit pouvoir établir
Le premier choix porte sur les questions à résoudre : qui a demandé une action, sur quel objet, à quel moment, avec quel résultat et par quelle voie ? Un événement structuré peut enregistrer un identifiant d’acteur, une opération, un objet référencé, un code de résultat et un identifiant de corrélation. Il n’a pas besoin du mot de passe, du document entier ou du cookie de session pour répondre à ces questions.
Le guide de journalisation OWASP insiste sur le choix des événements et des données à exclure. Les succès et échecs d’authentification, refus d’autorisation et actions à risque élevé donnent une matière utile à l’investigation. La liste exacte dépend du produit : collecter chaque détail sans finalité produit du bruit et agrandit le risque.
Le modèle de menace présenté dans notre analyse de la cybersécurité des agents aide à choisir ces événements. Une action automatique peut nécessiter l’identité de l’agent, celle de l’utilisateur qui l’autorise et la décision de politique appliquée. La copie d’un prompt complet n’est pas une preuve suffisante de ces trois éléments, et peut exposer beaucoup plus de données.
Une liste de champs autorisés plutôt qu’une liste infinie de secrets
La collecte la plus maîtrisable définit les champs attendus pour chaque événement. Par exemple, un export comporte l’acteur, le type d’export, le nombre de lignes, un périmètre référencé et un résultat. Son contenu n’est pas enregistré. Une connexion comporte une méthode, un résultat et les signaux strictement nécessaires à la détection. L’adresse IP peut être utile, mais sa précision et sa durée de conservation demandent un choix proportionné.
Le filtrage par noms de champs interdits reste fragile. Un jeton peut apparaître dans une URL, une erreur fournisseur ou une structure imbriquée. Une bibliothèque peut enregistrer automatiquement les en-têtes. Les exceptions de débogage doivent être temporaires, ciblées et relues. Dans un environnement de test, utiliser des données synthétiques réduit l’impact d’un réglage trop bavard.
Corréler sans recopier le contexte
Un identifiant de requête relie la passerelle, l’application et la tâche asynchrone. Il ne doit pas être dérivé d’un secret ni permettre d’obtenir la session correspondante. L’acteur reçoit une référence interne stable lorsque c’est nécessaire, avec des règles d’accès pour le rapprochement vers l’identité. Pseudonymiser un identifiant ne rend pas automatiquement les journaux anonymes si le rapprochement reste possible.
Le même identifiant ne doit pas transformer des données d’entrée libres en texte arbitraire dans les logs. Contrôler sa forme et sa longueur évite la pollution du format. Les caractères de contrôle présents dans une valeur utilisateur peuvent créer de fausses lignes dans un journal texte. Les formats structurés et l’encodage approprié réduisent ce risque, sans rendre les entrées fiables par magie.
Un export de dossiers déclenche une alerte
Exemple hypothétique : un compte d’administration exporte 12 000 dossiers alors qu’il en consulte habituellement quelques dizaines. L’événement indique le compte, le périmètre, l’horodatage, le volume, le résultat et la méthode d’authentification récente. L’investigateur retrouve la demande et confirme la décision d’accès. Il n’a pas besoin que les 12 000 dossiers aient été dupliqués dans le moteur de logs.
Une alerte sur le volume ne démontre pas une attaque : une opération de migration peut l’expliquer. La corrélation avec un changement de droits, une récupération de compte et un horaire inhabituel oriente la vérification. L’investigateur contacte le propriétaire par le processus interne prévu et examine les preuves. La règle de détection produit une piste, pas une conclusion automatique sur l’utilisateur.
Ce qu’un événement utile conserve
| Action | Champs utiles | Contenu à exclure |
|---|---|---|
| Connexion | Méthode, acteur référencé, résultat | Mot de passe et jeton de session |
| Export | Périmètre, volume, décision d’accès | Dossiers exportés |
| Appel fournisseur | Identifiant de requête et code d’erreur | Clé API et en-têtes complets |
| Changement de droits | Auteur, cible, droits avant/après nécessaires | Données personnelles sans lien avec l’action |
Protéger le système qui reçoit la preuve
Le compte de l’application peut écrire des événements sans recevoir le pouvoir d’effacer l’historique. Les consultations et les exports de logs sont eux-mêmes contrôlés. Les durées de rétention répondent à un besoin défini : investigation, support ou obligations applicables. Un stockage « au cas où » sans échéance multiplie la quantité exposée et complique le traitement des demandes liées aux données.
La collecte peut être interrompue sans que l’application cesse de répondre. Il faut donc surveiller les retards et les trous. Le comportement lors d’une saturation dépend de la criticité : une file bornée, une alerte et une stratégie explicite valent mieux qu’un remplissage silencieux du disque. Pour une opération où la traçabilité est indispensable, le choix de bloquer ou de différer doit être décidé avant l’incident.
Le temps mérite la même attention. Conserver l’instant de l’événement et, si utile, celui de son ingestion permet de distinguer une activité tardive d’un retard de collecte. La synchronisation des horloges et les fuseaux cohérents facilitent le rapprochement. Un timestamp affiché avec précision n’est pas à lui seul une garantie d’ordre ou d’exactitude.
Tester une fuite que le code ne devait pas produire
La recette utilise des valeurs de test reconnaissables dans les emplacements sensibles : mot de passe fictif, token synthétique, corps de document et en-tête d’autorisation. Elle provoque les succès, échecs et exceptions, puis cherche ces marqueurs dans toute la chaîne de collecte et les artefacts de diagnostic. Ce test détecte les chemins d’erreur que la lecture du schéma principal ne couvre pas.
Vérifier aussi les logs du proxy, du SDK fournisseur et des tâches de fond. Les connexions entre services peuvent enregistrer le même appel à plusieurs endroits. Corriger le seul logger applicatif laisse une fuite intacte dans la passerelle. Les liens partagés vers une enquête doivent respecter les mêmes droits que la consultation directe des données.
Moins de données, mais une meilleure question
Une revue régulière prend un incident représentatif et vérifie que les journaux permettent encore d’y répondre. Les champs inutiles disparaissent ; les informations manquantes sont ajoutées de façon ciblée. Le délai pour reconstruire une action, les événements non corrélables et les fuites détectées en recette sont des mesures plus utiles que le volume brut ingéré.
Le coût de stockage et de recherche appartient au coût d’exploitation de l’infrastructure. Une journalisation plus dense peut réduire ce coût et améliorer l’enquête, mais le gain doit être mesuré. La prochaine action consiste à choisir une opération sensible et à vérifier qu’elle reste explicable sans conserver son contenu.
Sources et références
Mise à jour du 1er octobre 2026 : références vérifiées à cette date. Les mécanismes décrits sont durables ; les options exactes restent à vérifier dans la version du produit utilisée.
- OWASP — Logging Cheat Sheet — événements utiles, exclusions, protection et tests des logs