Ce qu’il faut retenir
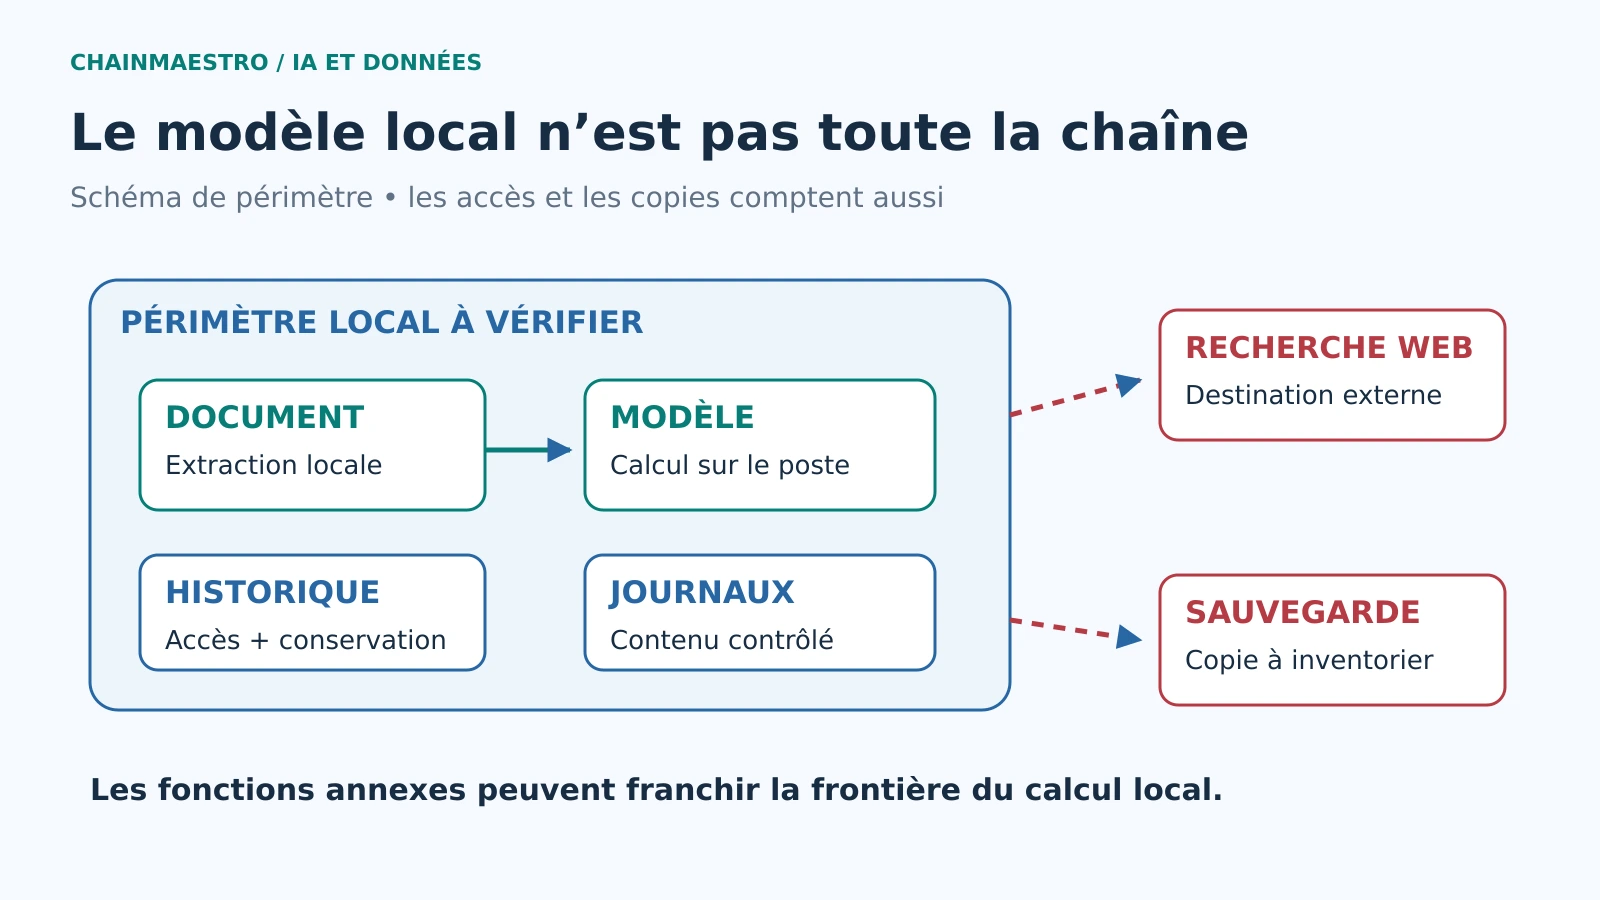
- Le lieu de calcul du modèle ne décrit pas toute la circulation des données. Recherche, extensions, télémétrie et sauvegardes peuvent franchir la frontière locale.
- Une promesse de confidentialité doit nommer les composants, les accès et les flux qu’elle couvre.
- Tester une application sans réseau puis observer ses connexions aide à établir ce qui reste effectivement sur le poste.
Références techniques consultées le 1er octobre 2026. Les réglages dépendent de la version installée et doivent être vérifiés avant usage.
« Le modèle tourne sur mon ordinateur » répond à une question précise : où s’exécute une partie du calcul. La phrase ne dit pas où le document a été extrait, où les embeddings ont été produits, ni quel service reçoit les journaux d’erreur. Pour une équipe qui manipule des dossiers clients ou du code confidentiel, cette distinction change la recette du produit.
Décrire la chaîne avant de choisir le modèle
L’inférence est l’exécution d’un modèle pour produire un résultat à partir d’une entrée. Elle peut se dérouler sur le poste, sur un serveur interne ou chez un prestataire. Une application ajoute souvent d’autres étapes : lecture de fichier, reconnaissance de texte, recherche documentaire, récupération de pages web et enregistrement de l’historique. Chacune a sa propre destination et sa propre politique d’accès.
Le dossier sur les modèles IA open source pour les PME aide à comprendre les choix d’exploitation. Des poids disponibles localement ne prouvent toutefois ni la liberté de tous les usages ni l’absence de communications réseau du logiciel qui les exécute. Examiner la licence du modèle et le fonctionnement de l’application reste nécessaire.
La FAQ officielle d’Ollama distingue fonctionnement local et modèles hébergés, documente un mode qui désactive les fonctions cloud et décrit l’adresse d’écoute du serveur. Ce sont des contrôles vérifiables dans ce produit, pas une garantie applicable à tous les outils d’inférence. La configuration réellement lancée doit correspondre à l’intention de l’équipe.
Quatre frontières à vérifier
| Frontière | Question concrète | Vérification |
|---|---|---|
| Réseau | Quelle étape appelle un service externe ? | Observer les destinations sur un scénario documenté |
| Poste | Quels comptes et applications lisent les fichiers ? | Permissions, sessions et répertoires de travail |
| Journalisation | Les requêtes ou pièces entrent-elles dans les traces ? | Inspecter un échantillon et les destinations des journaux |
| Conservation | Quelles copies survivent à la suppression ? | Historique, cache, synchronisation et sauvegardes |
Un serveur interne n’est pas un poste isolé. Une interface qui écoute sur le réseau peut être accessible à d’autres utilisateurs si les protections ne sont pas correctement installées. L’authentification, la limitation des origines web et le contrôle réseau jouent des rôles distincts. Autoriser une origine dans un navigateur ne remplace pas l’identification de l’utilisateur ni l’autorisation de consulter une pièce.
Les extensions constituent un autre passage. Un connecteur peut être local tout en envoyant une demande au service auquel il donne accès. Une recherche web transmet au moins une requête ; celle-ci peut contenir des informations dérivées d’un document privé. Le périmètre doit suivre ces données dérivées et pas seulement les pièces originales.
Les connexions MCP des agents rendent ces échanges plus faciles à organiser. Elles n’ajoutent pas, par leur seule présence, une garantie de confidentialité. Le service connecté garde ses propres règles, et l’application doit décider quelles données peuvent lui être adressées pour chaque tâche.
Une recette de confinement qui produit des preuves
- Tracer le parcours d’une pièce. Nommer les étapes, répertoires, services et identités. Inclure conversion, embeddings, génération, affichage et export.
- Préparer un document de test. Utiliser des valeurs fictives distinctives, reconnaissables dans les fichiers et les traces, sans employer de vraie donnée sensible.
- Exécuter sans accès externe. Après préparation des dépendances nécessaires, vérifier quelles fonctions restent disponibles et quels échecs apparaissent.
- Observer une exécution avec réseau. Relever les destinations et les moments des communications. Un nom de domaine ne révèle pas toujours le contenu transporté ; compléter avec les réglages et les traces autorisées.
- Inspecter les copies. Contrôler historique, cache, répertoires temporaires, journaux et synchronisation du poste.
- Rejouer après mise à jour. Une extension ou une version différente peut introduire un nouveau flux. Conserver une fiche de configuration datée.
Le test hors réseau ne prouve pas qu’aucune donnée ne partira plus tard. Une application peut mettre une transmission en attente ou conserver un fichier pour la prochaine connexion. Il faut examiner aussi le comportement lors du retour du réseau et la politique de conservation. Le but est de confronter les composants au périmètre déclaré, avec des résultats reproductibles.
Un assistant local de revue de contrats
Scénario hypothétique. Une société veut faire résumer ses contrats sur un poste dédié. Le modèle et l’extraction de texte sont locaux, mais l’interface propose une recherche automatique de clauses similaires sur le web. Le document n’est jamais envoyé intégralement ; des formulations propres au contrat peuvent pourtant être incorporées à la requête de recherche.
L’équipe crée un mode « dossier interne » qui interdit cette recherche et les outils externes. Les utilisateurs voient les capacités effectivement disponibles. Les journaux enregistrent identifiant de traitement, durée et type d’erreur sans recopier le contrat. Les exports sont placés dans un dossier protégé et la synchronisation du poste est vérifiée. Un mode de recherche externe, s’il reste utile, suit un circuit séparé avec des entrées adaptées.
La recette vérifie qu’un document peut tenter de demander l’ouverture d’une URL sans y parvenir. Une instruction trouvée dans une pièce reste une donnée non autorisée à modifier le périmètre. Les risques des agents IA concernent donc aussi les installations locales : un calcul sur le poste peut produire une action dangereuse si les outils ont trop de droits.
Confidentialité et capacité sont deux décisions
L’inférence locale peut améliorer la maîtrise de certains flux tout en imposant une capacité limitée. Mémoire disponible, taille du contexte, nombre de requêtes simultanées et délai acceptable déterminent les usages possibles. Une machine qui produit une réponse correcte en démonstration peut ralentir fortement quand plusieurs utilisateurs sollicitent le même modèle.
Mesurer sur les tâches retenues, avec les documents représentatifs et la charge prévue. Garder qualité, délai, taux de rejet et consommation de ressources. La quantification réduit la précision numérique des paramètres ou de certains caches ; son effet sur la qualité doit être testé pour la tâche, sans déduire une garantie générale d’une économie mémoire.
Le calcul économique prolonge l’analyse du coût de l’IA en entreprise : achat, administration, mises à jour, disponibilité et contrôle des accès s’ajoutent au calcul. Une architecture interne partagée peut convenir mieux qu’un modèle sur chaque poste, à condition que le périmètre de données et les responsabilités soient explicites.
La suppression compte autant que le premier traitement
Une pièce locale peut être copiée dans un historique de conversation ou dans un index. Supprimer le fichier d’entrée ne supprime pas nécessairement ses dérivés. Associer les fragments et sorties à un identifiant documentaire permet de les retrouver, puis d’appliquer la politique de conservation. Les copies de sauvegarde demandent un calendrier et un traitement adapté ; elles ne doivent pas être oubliées parce qu’elles sont moins visibles.
Les administrateurs, les personnes chargées du support et les outils de diagnostic ont parfois un accès plus large que les utilisateurs. Le périmètre de confidentialité doit les inclure. Pour les données personnelles, le fait de traiter sur place ne dispense pas d’analyser finalité, accès et conservation. Le présent guide décrit une recette technique ; une décision de conformité exige son propre examen.
La promesse que l’équipe peut tenir
Une formule exploitable précise les étapes confinées, les fonctions désactivées, les comptes autorisés, les copies conservées et la date de vérification. Elle peut aussi identifier une exception, par exemple le téléchargement initial du modèle ou une mise à jour administrée. L’exception doit correspondre au fonctionnement observé.
Avant d’autoriser un premier lot de documents sensibles, réunir la configuration, les résultats du test et le parcours de suppression. Ce dossier fait apparaître les trous de la chaîne. La confidentialité devient alors une propriété contrôlée de l’application entière, avec des limites documentées et une manière de vérifier qu’elles restent respectées.
Sources et références
Source primaire consultée le 1er octobre 2026 : Ollama, FAQ de configuration et de fonctionnement local. Les frontières, le protocole de test et le scénario de contrats sont des recommandations d’architecture ; aucune installation particulière n’est présentée comme auditée.