Ce qu’il faut retenir
- Une comparaison de modèles n’a de sens que si les questions, les attentes et les conditions d’exécution sont conservées.
- Un score moyen masque les erreurs rares qui coûtent cher. La recette doit identifier les catégories d’usage et leurs critères d’arrêt.
- Le jeu de test doit évoluer avec le produit tout en gardant un lot stable pour détecter les régressions.
Mise à jour du 1er octobre 2026 : références vérifiées à cette date.
Une équipe améliore son assistant, compare quelques réponses et annonce une progression. Trois semaines plus tard, un changement de consigne semble encore améliorer les résultats. Les questions ont pourtant changé entre les deux essais, les cas difficiles ont disparu et un annotateur évalue désormais la qualité du style plutôt que le respect des faits. Le produit a peut-être progressé ; la mesure ne permet plus de le démontrer.
Le test commence par le contrat du produit
Avant de choisir une métrique, écrire ce que l’utilisateur doit obtenir. Pour une classification, il s’agit d’une catégorie correcte selon une définition connue. Pour une extraction, de valeurs fidèles à la pièce. Pour une réponse documentaire, d’une information soutenue par une preuve. Pour un agent, d’une action autorisée sur le bon objet. Ces attentes imposent des recettes différentes.
Le cadre AI RMF du NIST traite l’évaluation comme une composante de la gestion des risques du système. Il s’agit d’un cadre volontaire, pas d’une certification produit. Son intérêt ici est de replacer la mesure dans un usage et une responsabilité, plutôt que dans un classement général de modèles.
Un contrat de test peut tenir dans une fiche : tâche autorisée, entrée acceptée, sortie attendue, critères bloquants et procédure d’escalade. « Réponse de bonne qualité » est trop vague. « La réponse fournit les champs présents, cite la pièce utilisée et s’abstient pour les champs absents » donne aux annotateurs un travail reproductible. Cette rigueur complète le panorama des outils IA qui font gagner du temps aux équipes : le gain dépend aussi de la fiabilité du résultat.
Conserver les cas, pas seulement leur moyenne
Chaque cas reçoit un identifiant durable. Sa fiche contient la question ou l’entrée, les documents nécessaires, les droits applicables, une sortie de référence et une explication des attentes. Les données personnelles ne doivent pas devenir le prix de la reproductibilité : anonymiser lorsque c’est compatible avec le test et contrôler l’accès aux cas qui exigent une pièce réelle.
Les familles doivent refléter le travail du produit. Un assistant de support peut distinguer question courante, exception contractuelle, incident, demande hors périmètre et demande ambiguë. Conserver des contre-exemples qui se ressemblent : un client actif et un client résilié, une facture et un avoir, une demande urgente et une demande qui contient seulement le mot « urgent ». Ils révèlent les raccourcis d’un classifieur.
Répartir les cas en lots de développement, de validation et de test final. Le premier sert à comprendre les erreurs. Le deuxième aide à arbitrer les modifications. Le dernier reste réservé à une décision de sortie. Réutiliser sans cesse le test final pour retoucher les consignes finit par lui donner un rôle de développement, même sans entraînement du modèle.
La documentation scikit-learn sur les erreurs courantes explique le risque de fuite entre entraînement et test. Dans une application générative, le même principe s’étend au travail sur les prompts, aux exemples fournis et aux documents accessibles pendant l’évaluation. La séparation doit porter sur les familles proches, pas uniquement sur les lignes d’un fichier.
Quatre versions à conserver ensemble
| Objet | Ce qu’il faut enregistrer | Pourquoi |
|---|---|---|
| Jeu de cas | Identifiants, contenu, exclusions et empreinte | Savoir quelles demandes ont été mesurées |
| Référentiel d’annotation | Définitions, exemples et arbitrages | Éviter qu’un changement de jugement devienne un gain technique |
| Système testé | Modèle, paramètres, consignes, outils, index | Identifier la cause plausible d’une variation |
| Exécution | Date, erreurs, sorties, durée et coût | Comparer les résultats et reproduire un incident |
Un modèle appelé par un nom commercial peut évoluer derrière ce nom. Enregistrer l’identifiant de version effectivement disponible et les réponses de l’essai ; si le fournisseur n’offre pas de version figée, indiquer cette limite. Une température identique ne garantit pas des sorties identiques. Les tâches variables méritent plusieurs exécutions, avec une dispersion, plutôt qu’un seul chiffre rassurant.
Les annotations peuvent changer lorsque le métier affine ses règles. Il faut alors versionner la grille et réévaluer les anciennes sorties sur la nouvelle grille si l’on veut une comparaison homogène. Un correctif de référence n’est pas honteux ; le masquer empêche de savoir si la progression vient du modèle ou du test.
Des métriques qui disent où agir
Pour une classification, distinguer précision et rappel : parmi les demandes envoyées dans une catégorie, combien y appartiennent réellement ; parmi toutes celles qui y appartiennent, combien sont repérées. La documentation officielle des métriques scikit-learn décrit ces mesures et leurs agrégations. Le choix dépend du coût d’un faux positif et d’un faux négatif.
Pour une extraction, mesurer chaque champ et le document complet. Pour une réponse, annoter soutien des affirmations, omissions et abstentions. Pour une action, vérifier l’objet ciblé, l’autorisation et le résultat obtenu. La fluidité de rédaction peut être notée séparément ; elle ne doit pas compenser une action interdite ni un montant inventé.
Garder les résultats par famille avec les effectifs. Une réussite parfaite sur cinq cas n’a pas la même portée que sur cinq cents. Quand les effectifs sont faibles, publier le nombre d’erreurs et examiner chaque cas. Les intervalles d’incertitude peuvent aider, mais ne résolvent pas un échantillon qui ignore une catégorie entière d’utilisateurs.
Une mise à jour qui gagne en moyenne et perd sur l’essentiel
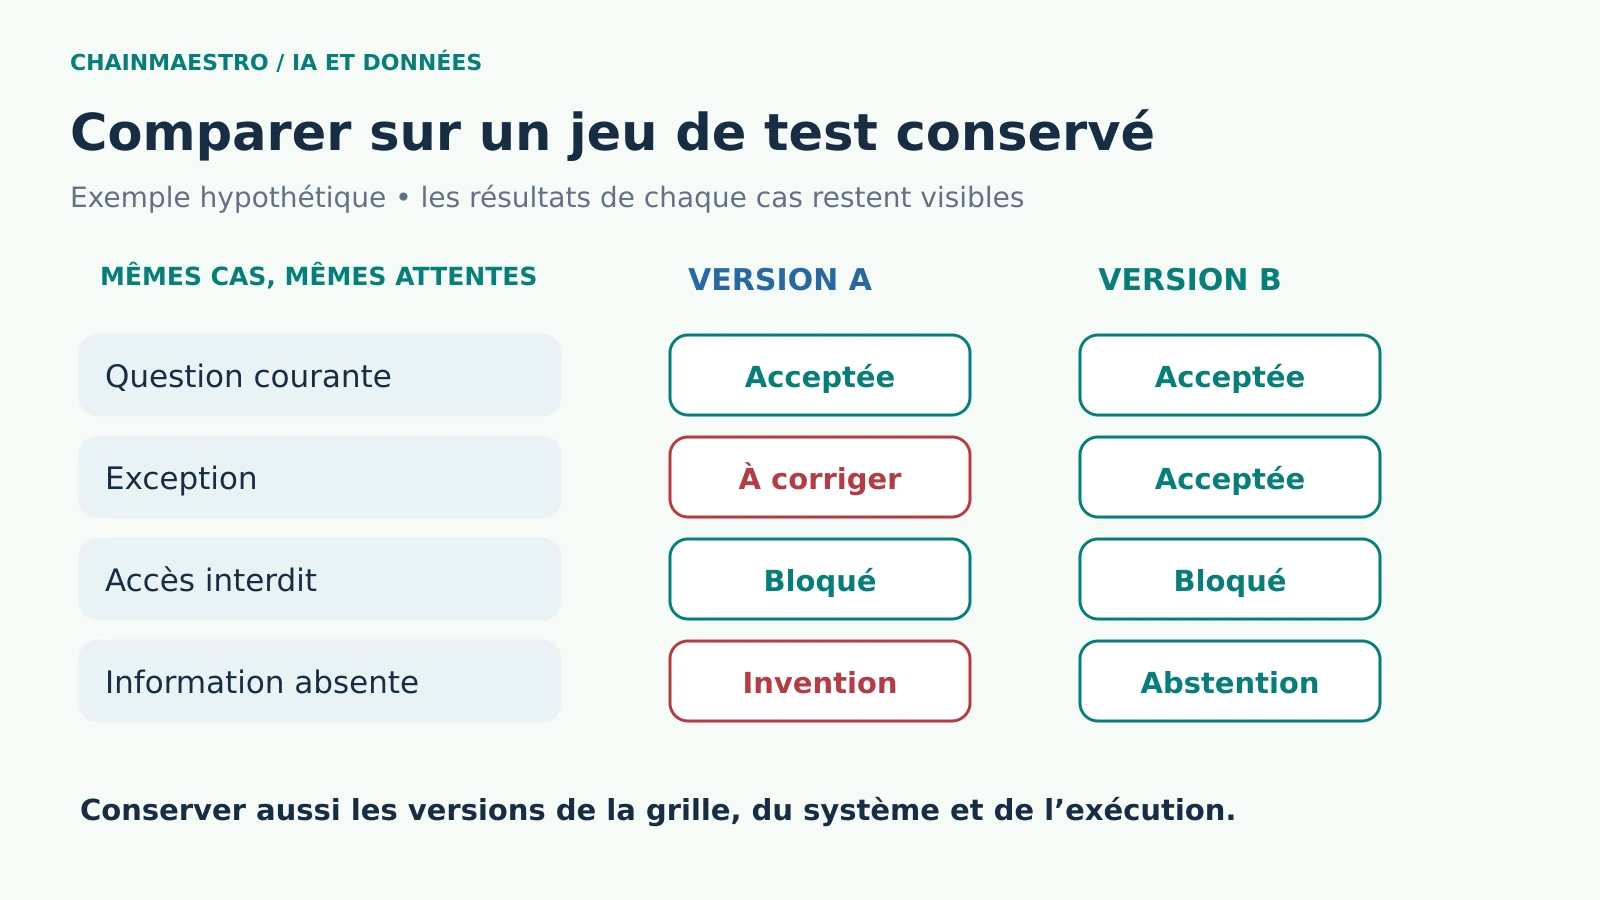
Scénario hypothétique. Un produit trie les demandes de support. Le nouveau modèle réduit les hésitations sur les questions simples, mais classe trop souvent les alertes de sécurité comme problèmes d’accès ordinaires. La moyenne globale progresse parce que les demandes simples dominent le trafic. Pour le responsable de support, la mise à jour n’est pourtant pas acceptable.
La grille réserve donc un critère bloquant aux alertes critiques. Les annotateurs examinent les faux négatifs et documentent le raisonnement métier, sans exiger du modèle une explication interne invérifiable. Une demande ambiguë peut rejoindre une file humaine. Le seuil de bascule n’est pas un chiffre universel : il dépend du volume, du délai de réponse et de la capacité réelle de cette file.
Une première activation limitée conserve un moyen de retour à la configuration antérieure. Les sorties sont échantillonnées sur le trafic réel, avec un accès restreint aux données. Le lot de test reste utile, mais il n’autorise pas à ignorer une nouvelle forme d’incident apparue après lancement. Les cas nouveaux sont intégrés au prochain lot daté ; les anciens gardent leurs identifiants.
Installer une décision de sortie simple
- Nommer un responsable d’acceptation. Il connaît l’usage et arbitre les erreurs qui ne peuvent pas être réglées par une moyenne.
- Définir les critères avant l’essai. Réussites attendues, erreurs bloquantes, coût et délai maximal par tâche.
- Comparer sur les mêmes cas. Garder les réponses anciennes et nouvelles, puis examiner les désaccords à l’aveugle quand c’est possible.
- Traiter les échecs techniques. Une réponse absente, tronquée ou non analysable reste un résultat ; elle ne disparaît pas du dénominateur.
- Publier une fiche de décision interne. Indiquer version retenue, limites connues, périmètre autorisé et condition de retour en arrière.
Le temps de construction du jeu, d’annotation et de maintenance fait partie du coût complet d’une application IA. Il peut sembler moins visible que la facture des appels, mais il évite de payer chaque régression dans les opérations. Pour un agent relié à plusieurs services, les connexions MCP et les outils disponibles doivent aussi figurer dans la version évaluée.
Un jeu versionné reste un échantillon
La reproductibilité ne garantit ni représentativité ni absence de biais. Des cas très propres peuvent favoriser un système qui échoue sur les pièces réellement reçues. Des annotateurs compétents peuvent aussi diverger sur une demande ambiguë : cette divergence doit produire un arbitrage ou une classe « indéterminée », pas une fausse vérité de référence.
Le premier livrable utile est un lot modeste, documenté et relu. L’élargir à partir des erreurs observées, en gardant les cas difficiles, donne une mesure qui résiste aux effets de démonstration. La question finale devient précise : quelle version peut accomplir cette tâche, avec quelles erreurs connues et quel recours humain ?
Sources et références
Références primaires consultées le 1er octobre 2026 : NIST, AI Risk Management Framework ; scikit-learn, séparation des données et fuites ; scikit-learn, métriques d’évaluation. Le scénario et la procédure d’acceptation sont des propositions méthodologiques.