Ce qu’il faut retenir
- Des vecteurs de même dimension ne sont pas nécessairement comparables lorsqu’ils viennent de modèles différents.
- Changer de modèle exige de vérifier la représentation des documents et des requêtes, puis de réévaluer la recherche.
- Une migration fiable conserve un index précédent et teste les accès, la fraîcheur et les suppressions avant la bascule.
Documentation consultée le 1er octobre 2026. Les modalités de migration dépendent du moteur et du modèle retenus.
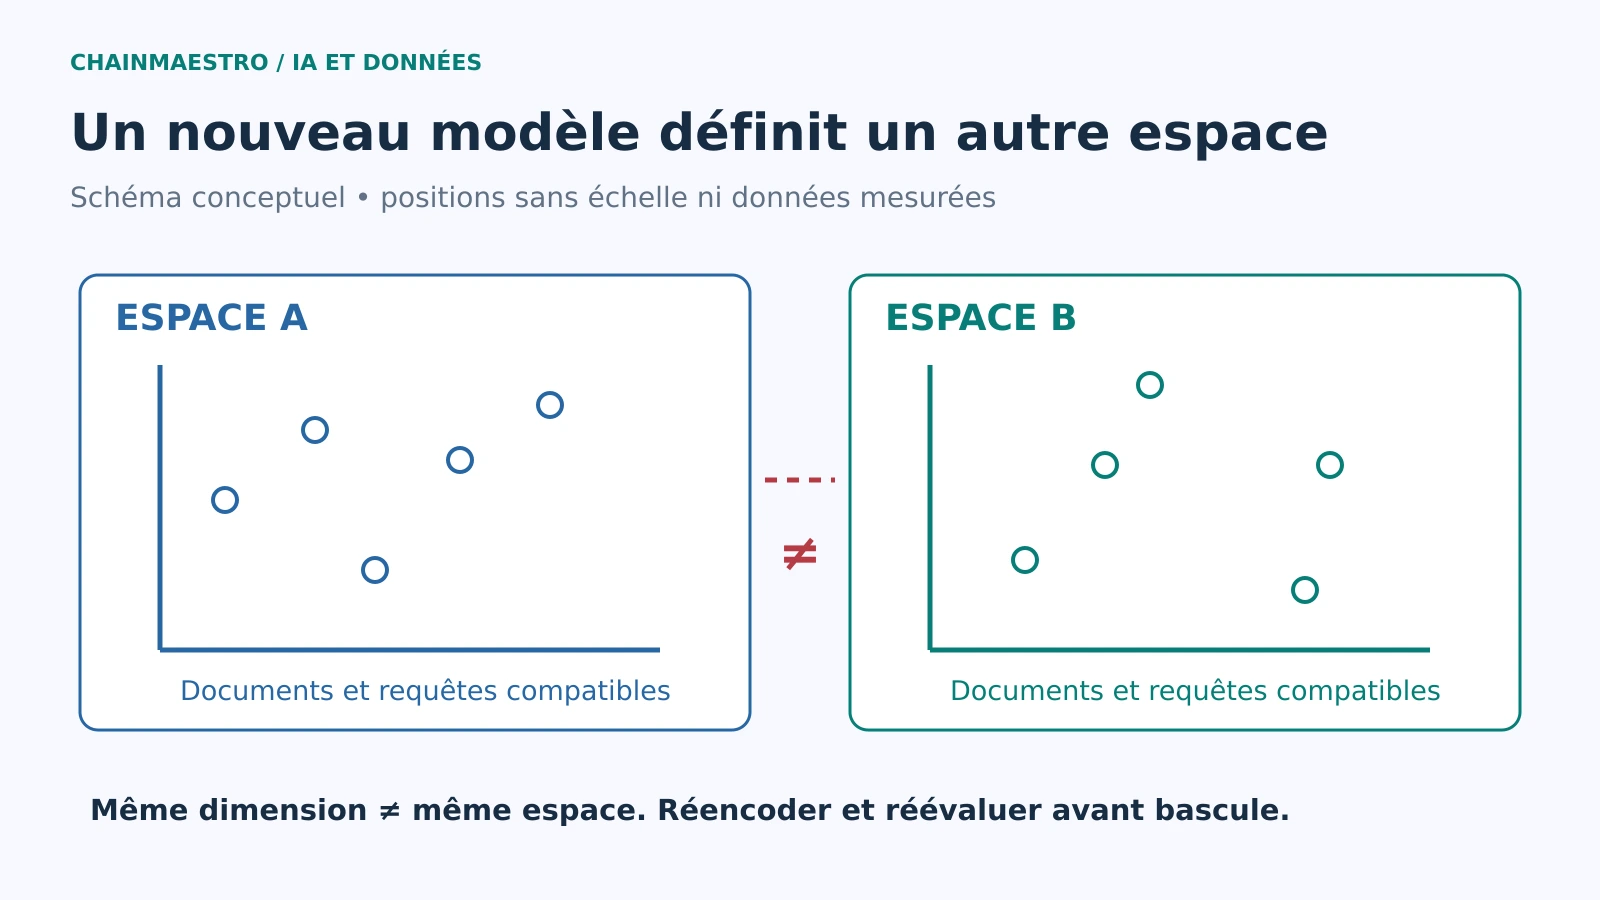
L’équipe remplace le modèle qui transforme les requêtes en vecteurs. L’API répond, les dimensions correspondent et la recherche renvoie encore des résultats. Pourtant, les documents pertinents descendent dans le classement. Le problème ne se voit pas dans la disponibilité du service : les nouveaux vecteurs sont comparés à des documents représentés dans un autre espace.
Ce qu’un embedding représente
Un embedding est une représentation numérique d’un objet, ici un texte. La recherche compare cette représentation à celles des documents pour retrouver des contenus proches selon la méthode choisie. Les coordonnées ne portent pas une signification universelle indépendante du modèle. Une dimension commune permet une opération mathématique ; elle ne prouve pas que l’opération donne une proximité pertinente.
La documentation Sentence Transformers sur la similarité présente plusieurs mesures et distingue notamment cosinus et produit scalaire. Elle précise la relation de ces mesures pour des vecteurs normalisés. Ce choix doit rester cohérent avec la façon dont les représentations sont produites et indexées.
Certains modèles distinguent le traitement des requêtes et des documents, par des consignes ou des encodeurs adaptés. Respecter cette convention est aussi important que le nom du modèle. Stocker sa version, la préparation du texte, la normalisation, la dimension et la mesure de distance permet de reconstruire la recherche effectivement exécutée.
La migration inclut le texte envoyé au modèle
Le découpage du corpus décide de ce que chaque vecteur décrit. Changer en même temps le modèle et la taille des fragments peut améliorer la recherche, mais rend plus difficile l’identification de la cause. Commencer par une comparaison à découpage constant, puis tester le découpage séparément, produit un diagnostic plus utile.
Les documents longs peuvent être tronqués selon le modèle ou le composant. Une exception située après la limite disparaît alors de la représentation. Le pipeline doit conserver ce qui a été réellement encodé, ou au minimum les paramètres et une empreinte du texte. Le nouveau modèle peut accepter une autre longueur ; ce changement doit être intégré au protocole plutôt que supposé sans effet.
Le choix d’un modèle local ou hébergé ajoute une contrainte de données. Réindexer peut transmettre l’intégralité d’un corpus à une nouvelle destination, même si la recherche quotidienne ne transmet que des questions. Cette dépense et ce flux prolongent l’analyse des modèles open source pour les PME et du coût réel de l’IA.
Créer un index séparé pour la comparaison
La méthode la plus lisible consiste à construire une nouvelle représentation à côté de celle en production. La documentation Qdrant sur les points décrit le stockage de vecteurs et de métadonnées associées. Les détails varient entre moteurs ; l’architecture doit surtout permettre d’identifier la représentation utilisée par chaque requête et de conserver les droits documentaires.
| Objet | À conserver | Contrôle avant bascule |
|---|---|---|
| Documents | Identifiant, version et fragments | Couverture du corpus attendu |
| Embeddings | Modèle, préparation et distance | Requêtes compatibles avec l’index |
| Métadonnées | Droits, dates et état de suppression | Filtres identiques sur les deux index |
| Recherche | Paramètres et version du reclassement | Qualité par famille de questions |
| Exploitation | Route active et procédure de retour | Retour à l’index précédent testé |
La compatibilité se juge sur le résultat. Une requête qui n’a pas de preuve dans le corpus doit pouvoir ne rien retourner d’utilisable. Les scores du nouveau modèle ne sont pas automatiquement comparables aux anciens. Réutiliser un seuil de distance parce qu’il a la même forme peut augmenter les réponses hors sujet ou les abstentions sans que le modèle soit intrinsèquement moins bon.
Comparer la recherche avant la génération
- Garder un lot de requêtes annotées. Indiquer documents pertinents, exceptions et cas sans réponse.
- Mesurer la présence de la preuve. Vérifier si elle apparaît parmi les premiers résultats, avec les mêmes filtres d’accès.
- Examiner les changements de rang. Un document attendu retrouvé trop bas peut ne jamais atteindre la génération.
- Calibrer les seuils. Tester les résultats faibles et les cas négatifs sur un lot distinct de celui qui a guidé le réglage.
- Rejouer la chaîne RAG. Contrôler ensuite les réponses, citations, omissions et délais sur les passages effectivement récupérés.
Une recherche peut améliorer ses classements et dégrader les réponses parce qu’elle remonte davantage de versions contradictoires. La recette complète vérifie donc hiérarchie documentaire et regroupement des fragments. La quantité de texte fournie au modèle ne constitue pas une métrique de qualité à elle seule.
Les critères doivent inclure les sigles, identifiants et noms propres du métier. Une recherche sémantique peut manquer une référence exacte ; une composante lexicale peut la préserver. Comparer la combinaison retenue avec une référence simple permet de vérifier que le nouveau modèle apporte une valeur sur les questions réelles.
Migrer un moteur de recherche de support
Scénario hypothétique. Un éditeur remplace les embeddings de sa base de support. Le lot contient questions générales, codes d’erreur et demandes propres à certains clients. L’ancien moteur répond bien aux codes exacts mais mal aux reformulations. Le nouveau améliore les reformulations et remonte parfois des notes clients interdites au profil de test.
La migration reste bloquée tant que les filtres ne fonctionnent pas de façon équivalente. Les permissions ne peuvent pas être échangées contre une meilleure pertinence. Après correction, l’équipe compare les résultats sur un lot figé, puis active la nouvelle recherche pour un périmètre limité. Les utilisateurs continuent à ouvrir les passages d’origine ; les sources ne sont pas remplacées par un score de similarité.
Une mise à jour documentaire survenue pendant la reconstruction est rejouée dans les deux représentations. Une suppression est également propagée aux deux. Le retour en arrière n’est acceptable que si l’index précédent a reçu les retraits et les changements de droits. Un index ancien mais complet techniquement peut être dangereux s’il restaure une pièce retirée.
Maintenir les deux index sans perdre les événements
La reconstruction doit avoir un point de départ identifiable, puis recevoir les changements intervenus depuis ce point. Un journal d’événements ou une procédure de rattrapage vérifiée évite l’écart entre le corpus actuel et la copie reconstruite. Les événements doivent être idempotents : un document mis à jour deux fois ne produit pas deux versions actives par accident.
La route active associe encodeur de requêtes et index correspondant. Les caches de résultats incluent cette version pour éviter de mélanger les réponses. Les contrats d’intégration API doivent rendre cette association explicite, en particulier lorsque plusieurs services consomment la recherche.
Prévoir un seuil d’arrêt sur les erreurs critiques et un responsable de bascule. Le suivi observe qualité sur un échantillon, latence, erreurs et part de requêtes sans résultat. Une hausse des abstentions peut être une amélioration sur un corpus bruité ou une régression sur des questions simples ; ouvrir les cas permet de trancher.
Le nouveau modèle ne corrige pas le corpus
Un corpus incomplet, contradictoire ou mal autorisé reste problématique avec de meilleurs embeddings. La similarité n’identifie ni la version juridique applicable ni la vérité d’une procédure. La recette doit rester documentaire et métier. Les tâches rares, les langues peu présentes et les pièces mal extraites peuvent exiger un lot spécifique.
Pour un assistant relié à des outils, le contexte retrouvé influence aussi les appels possibles. Les agents et connexions MCP doivent être retestés lorsque la recherche change leurs entrées. Le bon livrable de migration est une comparaison datée, une route explicite et un retour en arrière qui respecte le corpus courant.
Sources et références
Références primaires consultées le 1er octobre 2026 : Sentence Transformers, similarité textuelle ; Qdrant, points et vecteurs. La procédure de migration et le scénario sont des recommandations indépendantes de toute performance fournisseur.