Ce qu’il faut retenir
- La dérive peut venir des demandes, des documents, du métier ou d’un composant, même si le modèle n’a pas changé.
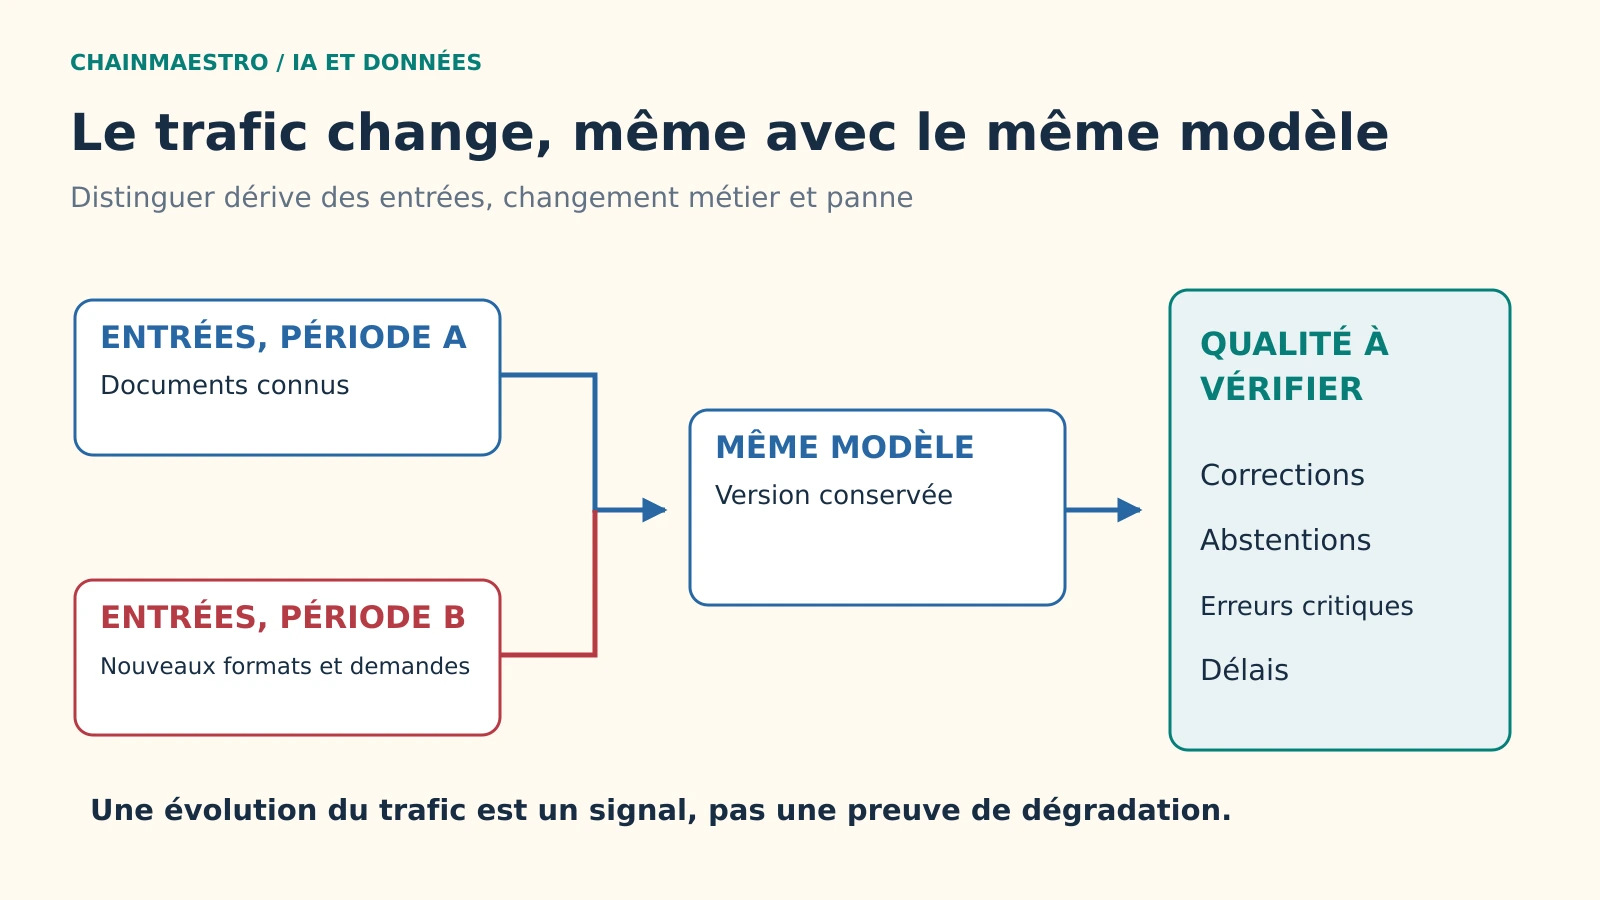
- Un changement statistique des entrées est un signal ; il ne démontre pas à lui seul une baisse de qualité.
- Le suivi doit relier alertes, échantillons annotés, erreurs critiques et décisions opérationnelles.
Références primaires consultées le 1er octobre 2026. Les seuils de suivi proposés doivent être calibrés sur l’usage concerné.
Le modèle n’a pas été modifié depuis sa recette. Pourtant, les corrections humaines augmentent. De nouveaux clients utilisent d’autres formats de documents, une catégorie de demandes apparaît et les procédures ont changé. La stabilité du composant de génération ne garantit pas celle du produit : l’application reçoit désormais un travail différent de celui sur lequel elle a été évaluée.
Quatre changements à distinguer
La dérive des entrées désigne une évolution de leur distribution : langues, longueur, qualité d’image ou catégories de demandes. Une dérive de relation apparaît lorsque la correspondance entre entrée et résultat attendu change, par exemple après une nouvelle règle métier. Une modification du modèle ou de ses consignes affecte le système lui-même. Enfin, une panne de composant peut produire les mêmes symptômes sans être une dérive statistique.
| Symptôme | Cause possible | Premier contrôle |
|---|---|---|
| Davantage de champs absents | Nouveaux documents ou extraction défaillante | Échantillon des pièces et erreurs de lecture |
| Changement de catégories | Nouveau trafic ou règle métier modifiée | Comparer volumes et annotations récentes |
| Réponses moins étayées | Corpus obsolète ou recherche dégradée | Preuves récupérées et versions documentaires |
| Retards et refus | Charge, quota ou service indisponible | Délais de chaque étape et codes d’erreur |
| Écart après une date précise | Configuration ou fournisseur modifié | Versions et événements de déploiement |
Cette séparation évite de réentraîner un modèle pour résoudre une panne d’OCR ou de recherche. Elle évite aussi de régler un seuil pour masquer une règle métier devenue différente. La première décision consiste à localiser le changement, puis à choisir un correctif adapté.
Le point de comparaison doit rester accessible
Conserver la version évaluée, le lot de test et les sorties de référence. Les paramètres de recherche, de routage, de normalisation et les outils disponibles font partie de cette version. Une API de modèle peut évoluer derrière un nom ; si l’équipe ne peut pas figer sa version, elle doit conserver cette limite et observer les sorties.
Le ML Test Score de Google Research met en avant l’importance des tests et du suivi pour l’exploitation du machine learning. Le point pratique est simple : une bonne performance avant lancement ne suffit pas sans une manière de détecter ses dégradations et d’y répondre.
Le cadre AI RMF du NIST inscrit également la mesure dans la gestion des risques du système. Il ne donne pas un seuil universel de dérive. Les limites acceptables dépendent des conséquences d’une erreur, du recours humain et de l’usage effectivement autorisé.
Observer les entrées sans confondre signal et résultat
Le suivi des entrées peut regarder proportion de langues, formats, sources, longueur et taux de valeurs manquantes. Ces signaux aident à repérer une population nouvelle ou une chaîne défaillante. Une différence n’est pas automatiquement un défaut : une campagne commerciale peut modifier le trafic tout en laissant la qualité intacte.
Compléter avec des résultats opérationnels : corrections, abstentions, rejets, délai et erreurs critiques. Les retours humains doivent avoir des catégories assez précises pour guider une action. « Mauvaise réponse » est insuffisant ; « mauvaise version de document » ou « montant associé au mauvais libellé » permet de tester une hypothèse.
Un score de similarité ou une confiance de modèle n’est pas un substitut à la qualité annotée. Sa distribution peut rester stable alors que la tâche change. Inversement, elle peut varier sans conséquence sur le métier. Les indicateurs indirects servent à déclencher un examen, puis la qualité est vérifiée sur des cas relisibles.
Le problème des résultats connus tardivement
Certains usages produisent rapidement une correction humaine. D’autres n’obtiennent leur référence qu’après plusieurs jours, ou seulement lorsqu’un incident survient. Le tableau de suivi doit distinguer cas évalués, cas en attente et cas jamais observés. Les seules réclamations ne forment pas un échantillon représentatif ; les utilisateurs peuvent accepter une erreur sans la signaler.
Prélever un échantillon régulier, puis ajouter un échantillon ciblé sur les alertes. Garder ces deux lots séparés dans les mesures. Le premier sert à estimer le fonctionnement courant ; le second sert à comprendre les défauts. Mélanger leurs moyennes peut donner l’impression que le produit se dégrade simplement parce que l’équipe inspecte davantage de cas difficiles.
La documentation scikit-learn sur les métriques permet de choisir des mesures adaptées à classification et repérage. Le suivi doit conserver effectifs et résultats par famille. Les petits volumes requièrent une lecture prudente ; quelques cas ne permettent pas d’inférer un changement durable de tous les usages.
Un assistant documentaire après une évolution du produit
Scénario hypothétique. Un éditeur lance une nouvelle option. La documentation courante est actualisée, mais des contrats plus anciens restent valides pour certains clients. L’assistant reçoit davantage de questions sur cette option et utilise trop souvent la nouvelle règle pour des comptes historiques. Le modèle n’a pas changé ; le corpus et la distribution des demandes ont changé.
Le suivi repère une hausse des corrections dans cette famille. Les annotateurs ouvrent les passages récupérés et identifient une erreur de priorité documentaire. L’équipe corrige le filtre selon le client et la période, puis rejoue le lot stable et ajoute les cas nouveaux dans un lot daté. Réentraîner le modèle sans traiter cette priorité aurait laissé la cause en place.
Une activation limitée permet de vérifier le correctif sur des demandes réelles. Les réponses sensibles conservent une validation humaine. Un retour à la version précédente est possible pour le code, mais le corpus doit rester à jour : revenir à une ancienne configuration ne doit pas restaurer une règle retirée ni un document devenu interdit.
Prévoir ce qui se passe après l’alerte
- Définir le propriétaire. Chaque alerte a une équipe responsable et une procédure d’examen.
- Vérifier l’instrumentation. Contrôler que la hausse n’est pas un changement de collecte ou un calcul incorrect.
- Ouvrir des cas. Comparer entrée, étapes intermédiaires, version et résultat attendu.
- Restreindre si nécessaire. Basculer une famille vers clarification ou validation humaine lorsque son risque augmente.
- Tester le correctif. Rejouer les anciens et nouveaux cas, avec coût et délai de bout en bout.
- Conserver la décision. Cause retenue, limites, responsable et condition de retour à l’automatisation.
Le suivi doit aussi vérifier la capacité de la file humaine. Déporter les cas difficiles sans regarder son délai peut transformer une dégradation du modèle en retard opérationnel. L’évaluation du coût réel de l’IA inclut ce travail de surveillance, d’annotation et de correction.
Le produit reste un ensemble de services
Les intégrations API ont leurs propres versions, délais et erreurs. Les agents connectés par MCP peuvent recevoir de nouveaux outils ou des résultats différents. Ces changements doivent rejoindre l’historique du système pour que l’équipe puisse expliquer une variation.
Les gains de temps des équipes se mesurent sur la durée. Une fonctionnalité utile au lancement peut imposer davantage de corrections après une évolution du métier. Le suivi sert à choisir où maintenir l’automatisation, où la restreindre et où améliorer les entrées.
Une alerte ne nomme pas automatiquement la cause
Les tests statistiques et les tableaux de bord orientent l’enquête ; ils ne démontrent pas tous seuls une causalité. Plusieurs changements peuvent coïncider. Conserver versions, étapes et cas permet de construire une hypothèse puis de la tester. Les seuils trop sensibles créent une fatigue d’alerte ; les seuils trop larges masquent les défauts rares.
Avant de généraliser un système IA, simuler une dérive et vérifier la réaction : qui reçoit l’alerte, quels cas il ouvre, comment il limite le périmètre et quelle preuve autorise le rétablissement. La qualité en production exige cette capacité de décision, en plus d’un score obtenu avant lancement.
Sources et références
Sources primaires consultées le 1er octobre 2026 : Google Research, The ML Test Score ; NIST, AI RMF ; scikit-learn, métriques. Le scénario et la procédure de réaction sont méthodologiques.