Ce qu’il faut retenir
- La longueur d’une file ne suffit pas pour dimensionner des workers : durée de traitement, âge des tâches et capacité disponible comptent aussi.
- Une politique d’autoscaling doit protéger le délai métier tout en limitant la pression sur les services en aval.
- Tester une montée en charge, une panne de métrique et une réduction de capacité révèle les risques que le seul scénario nominal masque.
Le CPU reste à 25 %, mais les exports attendent depuis huit minutes. L’autoscaler ne bouge pas : il surveille une ressource peu sollicitée pendant que les workers attendent des lectures distantes. L’équipe peut ajouter des machines manuellement. Elle doit surtout choisir un signal qui représente le délai réellement subi.
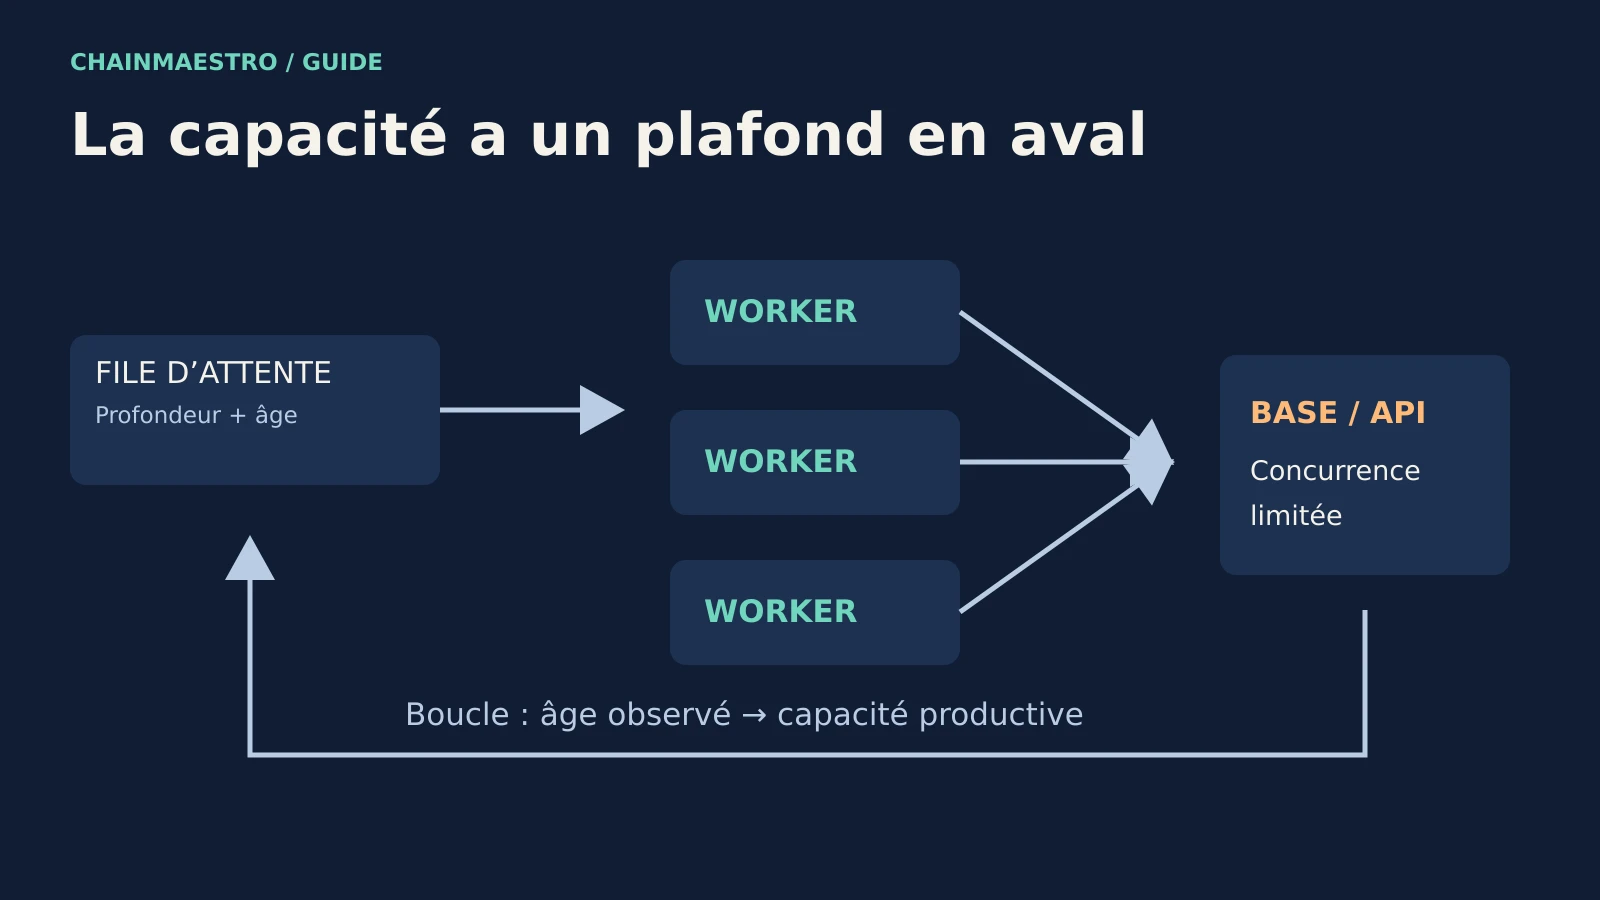
Une file d’attente absorbe une pointe, mais elle n’efface pas le travail. Lorsque le rythme des arrivées dépasse celui des traitements, l’arriéré augmente. L’autoscaling devient utile si les nouvelles capacités peuvent réellement accélérer ce traitement, sans saturer la base ou une API externe.
Observer le travail restant et son âge
La profondeur de file compte les tâches disponibles. L’âge de la plus ancienne tâche représente une autre information : cent messages rapides peuvent être moins urgents que dix calculs bloqués depuis une heure. Ajouter le taux d’arrivée, le taux de réussite et la durée de traitement permet de distinguer surcharge, panne et tâches exceptionnelles.
Le nombre de tâches en cours complète le tableau. Une file vide peut coexister avec de nombreuses opérations longues déjà prises en charge. Un autoscaler qui ne regarde que les messages disponibles risque de retirer de la capacité pendant que le travail se poursuit.
La documentation AWS sur le scaling fondé sur SQS propose notamment une mesure d’arriéré par instance, liée à une latence acceptable et au temps moyen de traitement. La logique rappelle que la quantité seule n’indique pas le nombre de machines nécessaire.
Partir d’un objectif de délai métier
Définir ce que le service promet : démarrer un export sous deux minutes ou terminer un traitement en dix minutes. Le délai en file, la durée de calcul et les tentatives répétées doivent tenir dans cet objectif. Une métrique de démarrage ne protège pas automatiquement le temps jusqu’au résultat final.
Le coût d’une infrastructure de traitement doit être relié aux opérations réussies. Les reprises et les erreurs consomment de la capacité sans produire le service attendu. Une hausse de machines peut donc augmenter la facture tout en laissant le retard intact.
Pour des tâches homogènes et un worker qui les traite séquentiellement, on peut estimer une cible d’arriéré par worker en divisant le délai d’attente souhaité par la durée moyenne d’une tâche. C’est une approximation de dimensionnement, pas une garantie de percentile : arrivées irrégulières et tâches longues demandent une recette plus réaliste.
Quatre workers ne suffisent pas toujours à réduire le retard
Considérons un exemple hypothétique. Un service traite une tâche en deux secondes en moyenne. Le délai d’attente visé est de 60 secondes. Une cible indicative de 30 tâches par worker en découle. Avec 240 tâches disponibles, une capacité de huit workers correspond à cette cible théorique.
Mais le démarrage d’un worker prend 45 secondes. Si la pointe dure peu, la nouvelle capacité arrive après une grande partie du retard. L’équipe peut conserver une capacité minimale ou anticiper les pointes connues. Elle doit comparer le coût de cette disponibilité au délai évité.
Autre limite : la base ne supporte que six traitements concurrents. Passer à huit workers augmente les conflits, allonge les tâches et multiplie les reprises. Le calcul initial cesse d’être valide puisque la durée de traitement change avec la capacité. Le plafond doit donc être défini par une mesure de charge, avec une réserve pour les autres usages de la base.
Une boucle de contrôle a des retards
La métrique est collectée, agrégée puis lue ; le contrôleur décide ; la capacité démarre ; elle devient productive. Chaque étape ajoute un délai. Une montée agressive fondée sur une observation ancienne peut dépasser le besoin au moment où les workers sont prêts. Une descente trop rapide peut recréer l’arriéré quelques minutes plus tard.
La documentation Kubernetes sur l’autoscaling horizontal décrit le fonctionnement du contrôleur et les réglages de comportement. Les bornes et les fenêtres de stabilisation doivent être adaptées au workload. Copier une configuration générique sans observer les retards de démarrage donne une boucle difficile à expliquer.
| Paramètre | Question utile | Risque à tester |
|---|---|---|
| Capacité minimale | Quel travail doit démarrer sans attente de création ? | Coût de disponibilité permanent |
| Capacité maximale | Que supporte réellement l’aval ? | Saturation et retries en cascade |
| Montée | À quelle vitesse la capacité devient-elle productive ? | Réaction trop tardive ou excessive |
| Descente | Comment terminer les tâches actives ? | Interruption et doublons |
| Métrique absente | Quelle capacité reste sûre ? | Suppression aveugle des workers |
Le scaling doit respecter les traitements en cours
Une réduction de capacité doit prévoir un arrêt gracieux : arrêter de prendre du travail, finir ou transférer proprement ce qui est actif, puis quitter. La file peut remettre une tâche à disposition après une interruption. L’application doit donc supporter des livraisons répétées et empêcher que deux essais produisent deux effets métier.
Utiliser un identifiant de tâche stable et une preuve de résultat aide à rendre l’opération idempotente. Si un paiement, un email ou une écriture externe a peut-être déjà eu lieu, un simple retry aveugle peut créer un doublon. Réconcilier l’état fait partie du traitement, même si l’infrastructure de file annonce une reprise.
Les intégrations API rendent cette limite très concrète : ajouter des workers ne relève pas les quotas d’un partenaire. Une stratégie de concurrence et de temporisation doit préserver la disponibilité du service externe.
Tester le service et la facture ensemble
- Mesurer la capacité d’un worker. Utiliser des tâches représentatives et observer la distribution des durées, pas seulement la moyenne.
- Simuler une pointe. Conserver arrivées, profondeur, âge, capacité productive et opérations réussies sur une même chronologie.
- Tester l’aval dégradé. Vérifier plafonds de concurrence, temporisation et séparation des tâches problématiques.
- Couper la métrique de test. Observer le comportement choisi lorsque le contrôleur ne reçoit plus de données fiables.
- Réduire la capacité pendant le travail. Vérifier l’arrêt gracieux et l’absence d’effets métier répétés.
- Calculer le coût par résultat utile. Comparer à la politique précédente avec le même profil de charge.
Une file de tâches exceptionnellement longues peut nécessiter une classe de workers ou une priorité séparée. Sans cela, un cas atypique dégrade les délais de toutes les petites tâches. Cette séparation doit suivre un besoin observé ; elle ajoute elle-même des règles de routage et de maintenance.
Un autoscaler ne corrige pas une demande sans limite
Si le produit accepte toujours plus de travail sans quotas ni information d’attente, aucune capacité maximale ne garantit le délai. Prévoir admission, limites par client ou dégradation explicite permet de maintenir un service compréhensible. Le retour économique de l’automatisation dépend aussi de cette maîtrise de la demande.
La prochaine revue devrait comparer trois courbes : âge des tâches, capacité réellement productive et coût. Si la capacité monte sans réduire l’âge, chercher le goulot ou les reprises avant d’augmenter le plafond.
Sources et références
Sources primaires consultées le 1er octobre 2026 : AWS, scaling basé sur SQS et Kubernetes, Horizontal Pod Autoscaling. Le dimensionnement chiffré est hypothétique et repose sur des tâches homogènes ; les paramètres effectifs doivent être mesurés.