Ce qu’il faut retenir
- Un quota limite un consommateur ; la protection contre la surcharge doit aussi tenir compte de la capacité globale.
- Les files et les nouvelles tentatives doivent être bornées, faute de quoi elles prolongent l’incident.
- Un refus explicite et documenté vaut souvent mieux qu’une requête acceptée qui attend jusqu’à devenir inutile.
Une campagne augmente le trafic. Le serveur web tient, mais les connexions à la base s’épuisent et les tâches d’import s’accumulent. Les clients réessaient. Chaque nouvelle tentative consomme de la capacité qui aurait pu terminer les premières opérations. La panne est entretenue par les mécanismes censés la rendre tolérable. La réponse exige de décider ce que le service accepte, ce qu’il reporte et ce qu’il refuse.
Le débit, la concurrence et la file mesurent des choses différentes
Le débit compte les opérations sur une durée. La concurrence compte celles qui travaillent au même instant. La file contient celles qui attendent. Une API peut respecter un quota de requêtes par minute tout en saturant son pool de base si chaque requête dure longtemps. Elle peut également avoir une faible concurrence instantanée et une file trop vieille pour répondre aux besoins du produit.
La RFC 6585 définit le statut HTTP 429 pour signaler qu’un utilisateur a envoyé trop de requêtes sur une période. Elle permet une indication Retry-After. Ce statut ne définit ni l’identité du consommateur ni la méthode de comptage. Le produit doit préciser le contrat ; recopier une valeur dans un reverse proxy ne le fait pas.
La documentation Google SRE sur la surcharge montre l’intérêt de réduire la demande et de maîtriser l’admission. Les mécanismes exacts se choisissent à partir du goulet réel : CPU, mémoire, base, fournisseur ou durée du traitement. Augmenter le nombre de workers peut aggraver la situation s’ils se disputent la même ressource limitée.
Une limite doit être intelligible pour le client
Définir le quota par compte, clé ou organisation évite de pénaliser tous les utilisateurs derrière une même adresse IP. Les routes publiques peuvent aussi nécessiter des protections par origine, mais elles ne remplacent pas la règle métier après authentification. Les utilisateurs partagés, proxys et applications mobiles rendent l’adresse seule imparfaite pour exprimer un droit de consommation.
Le contrat distingue une pointe autorisée et une consommation soutenue. Un algorithme de seau à jetons permet, selon sa configuration, une réserve temporaire puis un débit régulier. Une fenêtre fixe peut autoriser une pointe autour de sa frontière. Aucun choix ne crée de capacité supplémentaire. Il faut tester son comportement sur des requêtes simultanées et en déploiement distribué.
Les intégrations API ont besoin de messages lisibles : périmètre touché, délai conseillé lorsqu’il est disponible et identifiant de diagnostic. Le client respecte la temporisation, applique une attente progressive et une variation aléatoire pour éviter un réveil simultané. Le nombre d’essais et la durée totale sont limités. Une nouvelle tentative d’écriture exige aussi une protection contre les effets répétés.
La backpressure ferme la boucle
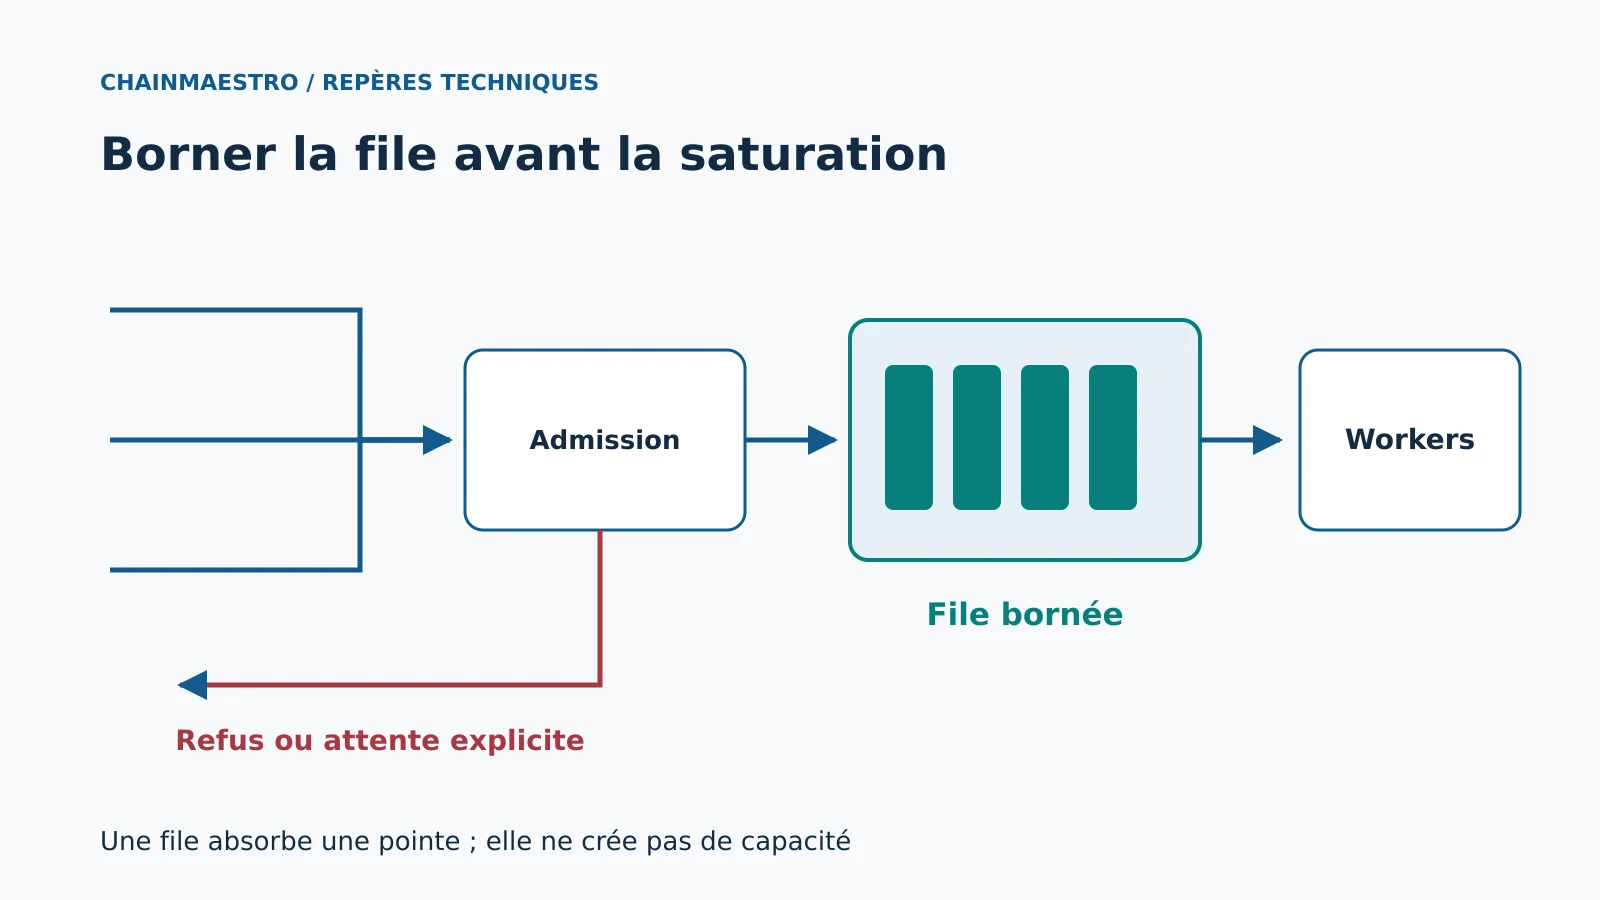
La backpressure, ou rétropression, transmet la saturation vers l’amont afin qu’il réduise ou arrête la production. Une file sans borne absorbe temporairement la pointe puis stocke le problème. Elle consomme mémoire ou disque, augmente le délai et maintient du travail devenu obsolète. Une file bornée oblige à choisir une politique : refus, report, remplacement d’un travail ancien ou dégradation d’une fonction.
Le choix dépend du métier. Un recalcul de recommandation peut être remplacé par le plus récent ; une opération de facturation exige une trace durable et ne se jette pas silencieusement. Les priorités doivent protéger le chemin essentiel sans affamer les autres opérations indéfiniment. Mesurer l’âge du plus ancien travail et son temps prévu est souvent plus éclairant que compter les éléments.
Propager une échéance utile
Une requête dont le client a abandonné peut continuer à consommer la base. Les timeouts de chaque couche doivent former un ensemble cohérent, et l’annulation doit être propagée lorsque les outils le permettent. Un traitement asynchrone peut continuer après l’abandon si c’est le contrat annoncé ; il fournit alors un identifiant de suivi. Il ne prétend pas que l’opération est achevée simplement parce qu’elle a été acceptée.
Fixer un délai maximal d’attente dans la file évite d’exécuter tard un travail sans valeur. Un export nocturne peut tolérer des minutes ; une recherche interactive non. L’API distingue ces parcours et ne les met pas en concurrence dans une seule file aveugle. Le coût supplémentaire d’une capacité dédiée se compare au coût produit d’un rejet ou d’un délai.
Une importation massive rencontre le parcours interactif
Exemple hypothétique : un SaaS accepte des imports de catalogues et sert des recherches interactives. Un client dépose 200 fichiers. Chaque import consomme des connexions à la base. L’équipe borne à quatre le nombre d’imports simultanés et plafonne la file en fonction de la durée acceptable. La recherche dispose d’un budget séparé. Ces nombres illustrent une politique ; ils ne sont pas des valeurs universelles.
À la limite, le service indique qu’un nouveau travail n’est pas accepté ou lui propose un report explicite. Il ne renvoie pas un faux succès. Les tentatives du client sont étalées. Un import déjà accepté conserve son identifiant et son état afin qu’une réponse perdue ne crée pas un deuxième import. Les événements d’admission, refus et terminaison permettent de reconstruire l’histoire sans recopier le contenu des fichiers.
Les contrôles à placer sur la chaîne
| Point | Limite | Indicateur utile |
|---|---|---|
| Entrée API | Quota par consommateur et route | Refus et consommation soutenue |
| Exécution | Concurrence par ressource critique | Temps d’attente et saturation |
| File | Taille et âge maximal | Travail ancien et expiré |
| Client | Essais et durée totale | Amplification liée aux reprises |
Tester la récupération autant que la pointe
Un test de charge commence par une capacité de référence sur un environnement adapté et isolé. Il augmente la demande, simule un ralentissement fournisseur et observe les refus. Il vérifie surtout ce qui se passe après la pointe : la file se vide-t-elle dans un délai acceptable ? Les clients continuent-ils à réessayer ? La mémoire revient-elle à son niveau habituel ? Une moyenne de latence peut masquer la minorité qui reste bloquée.
Le parcours essentiel doit être mesuré séparément. Si le catalogue reste rapide mais que la création de commande échoue, un indicateur global flatteur trompe la décision. Les méthodes de mesure par parcours s’appliquent aussi à la fiabilité : le dénominateur et la segmentation doivent correspondre à l’usage qui compte.
Le quota ne remplace pas le budget d’infrastructure
Une limite trop basse cache un sous-dimensionnement ; une limite trop haute transforme un abonnement en risque pour tous les autres. La capacité se discute avec les offres commerciales, les durées de traitement et le coût des fournisseurs. Elle entre dans le coût réel des API et de l’infrastructure, y compris pour les services facturés par appel.
La prochaine action consiste à sélectionner une route critique, à relever ses trois limites — débit, concurrence et attente — puis à tester un ralentissement de sa dépendance principale. Si une seule de ces valeurs reste implicite, la politique de surcharge est encore incomplète.
Sources et références
Mise à jour du 1er octobre 2026 : références vérifiées à cette date. Les mécanismes décrits sont durables ; les options exactes restent à vérifier dans la version du produit utilisée.
- IETF — RFC 6585 (2012) — statut 429 et Retry-After
- Google — Site Reliability Engineering, Handling Overload (2016) — admission et réaction à la surcharge